AI资讯
Google 发布 Gemini Decisions API:单次前向传播完成最多 1000 个多模态判断,输出 token 不计费
Google 于 2026 年 11 月 11 日推出 Gemini Decisions API,由新模型 Gemini Decision 1(gemini-decision-1)驱动,通过 Google AI Studio 的 Gem…
标签
共 19 篇资讯
Google 于 2026 年 11 月 11 日推出 Gemini Decisions API,由新模型 Gemini Decision 1(gemini-decision-1)驱动,通过 Google AI Studio 的 Gem…
Google 推出 Gemini Decisions API,对应模型名为 Gemini Decision 1,正式进入由 Jev 和 OpenAI 开创的「决策模型」品类。该 API 与 Jev 高度相似:同样支持 yes/no、ch…
腾讯混元 11 月 4 日正式发布 Hy4,主打性价比的轻量版 Hy4 flash 同步亮相,模型权重将在近期开源。腾讯给它的定位是首次跻身最强开源模型之列。极客公园围绕长程 Agent、多模态理解与视觉代码三条主线做了实测:在接近买方…
Liquid AI 发布第三代 Liquid Foundation Models(LFM3),以 LFM3-1.7B-Base 为统一骨干,衍生出文本、视觉、音频、全模态和决策共六款 2B 级模型。官方称 LFM3-1.7B 以比 LF…
Google DeepMind 于 2026 年 10 月 27 日发布新一代世界模型 Genie 4,主打四项能力:用自然语言实时修改模拟场景、物理与人物动作的真实感提升、原生生成环境音与可交互对话、以及借助 Gemini 模型模拟多…
Meta 通过 Hugging Face 发布开源权重模型 Muse Spark Open,这是一个混合专家(MoE)架构的多模态模型,总参数量约 816B,每 token 激活约 42B,上下文窗口最高 1M token。模型支持文本…
NVIDIA 发布 Nemotron 3.5 Super VL,一个面向常驻企业 Agent 的开源视觉语言模型。该模型为 120B 总参数、12B 激活参数的 MoE 架构,支持最高 1M token 上下文,可同时处理文本、图像、文…
Meta 推出名为 Muse Spark Open 的开源权重模型,参数规模达 8160 亿,支持文本、图像、视频和音频四种模态输入,上下文窗口最高可达 100 万 token。在基准测试中,它的表现大致与目前能力最强的中国开源权重模型…
在今年的云栖大会上,阿里把外界最关心的三个模型问题摆上台面:下一代 Qwen 做多大、迭代能多快、多模态能不能打。千问大语言模型负责人刘大一恒给出模型规划路线图:Qwen4 系列即将到来,之后的 Qwen4.5 和 Qwen5 计划进一…
OpenAI 本周将 Decisions API 开放公测,并为其加入图像输入能力,可基于视觉内容快速做出判断。该 API 运行在 GPT-6 Luna 上,定价为每 100 万输入 token 0.10 美元,不收取输出 token…
Liquid AI 发布 Open d1 系列两个开源权重多模态模型:d1-3B(3.12B 参数,读文本与图像)和 d1-omni-600M(587M 参数,读文本+图像或文本+音频)。两者都不输出文本,而是在一次前向传播中针对命名问…
10月12日,模思智能宣布完成超10亿元Pre-A轮融资,由华控基金领投,国开科创、上海科创基金、新微资本、徐汇资本、追光硬科技创投、临港策源基金等参与,老股东元禾控股、上海国投旗下上海科创集团、星连资本继续投资。该公司由复旦大学特聘教…
据雷峰网报道,前腾讯混元视觉大模型算法中心负责人胡瀚的创业项目已有新进展。项目方向仍聚焦多模态,计划融资数千万美元,目标估值达数亿美金,远识资本担任本轮融资 FA。过去一个月已有多家投资机构与胡瀚接触,商业化是机构反复追问的问题。胡瀚给…
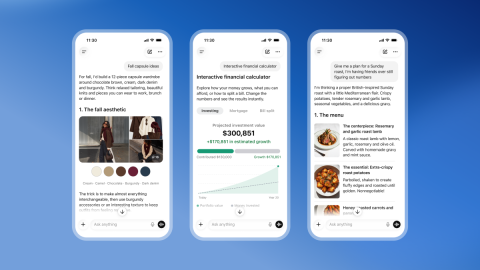
OpenAI 发布名为 Intelligent UI 的新界面,随新模型 GPT-6 一同上线,把大量可视化内容引入 ChatGPT 对话。与以往扁平的卡通插图不同,这些视觉元素是可交互的,包括可点击按钮、针对特定任务定制的计算器、交互…
豆包工作近期更新,推出面向复杂创作任务的创作画布功能,并接入轻量级模型豆包2.1 Lite。画布功能将素材、设计方案与创作成果集中到同一无限画布页面,用户可在图片生成后继续修改文字、配色和布局,同时接入全新图片模型Seedream 5.…
OpenAI 官方博客介绍了客户案例 Pollo AI:该产品使用 GPT-5.6、GPT-6 Astra 和 GPT-Image-2.5 三款模型,帮助创作者把创意想法转化为细节丰富的图像和电影级视频广告。原文仅给出这一句概括,未披露…
Google DeepMind 于 9 月 15 日发布两款实时语音对话模型 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking,主打近实时推理、实时视觉理解和后台任务执行。其中 3.…
Google DeepMind 于 2026 年 9 月 24 日发布 Gemini 3.8 Live with Live Avatar,在上一周 Gemini 3.8 Live 的基础上,为原生实时对话模型加入近实时的视觉形象。该功能…
Google DeepMind 发布 Gemini 的智能体视频理解(agentic video understanding)功能,已在 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 三款模型上…