Liquid AI 发布 LFM3 系列:2B 参数级六款多模态模型共享同一骨干,单卡可微调
来源Hugging Face Blog查看原文
速览
- LFM3 用统一 1.7B 骨干衍生六款多模态模型,覆盖文本、视觉、音频、全模态和决策。
- 新 tri-hybrid 架构让 1.7B 模型性能超过前代 2.6B,参数减少 35%。
- 文本模型 4-bit 量化后约 1 GB,256K 上下文,面向端侧 Agent 场景。
- 视觉模型首次支持视频输入,62 项基准平均分从 57.6 升至 71.4。
- 音频模型支持 18 种语言,首 token 延迟低至 50 ms,语音质量提升。
- 全模态模型 LFM3-Omni-2B 在音视频理解基准上超过 Qwen2.5-Omni-7B 等更大模型。
- d1 决策模型单次前向回答多个问题并给出校准概率,d1-2B 替代 d1-3B。
- 所有模型开放权重,单卡可微调,提供 Colab 微调教程。
- 机器人 VLA 在 LIBERO 套件达 96.2% 成功率,Jetson 上动作生成低于 50 ms。
Liquid AI 发布第三代 Liquid Foundation Models(LFM3),以 LFM3-1.7B-Base 为统一骨干,衍生出文本、视觉、音频、全模态和决策共六款 2B 级模型。官方称 LFM3-1.7B 以比 LFM2.5-2.6B 少 35% 的参数实现更强性能,在 WebArena-Verified 上得分 38.42,而前代为 3.02。所有模型均为开放权重,已在 Hugging Face 上线,并可在单张 GPU 上微调。
关键事实
- LFM3 系列包含 LFM3-1.7B、LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2B、d1-2B、d1-omni-2B 六款模型,均基于 LFM3-1.7B-Base。
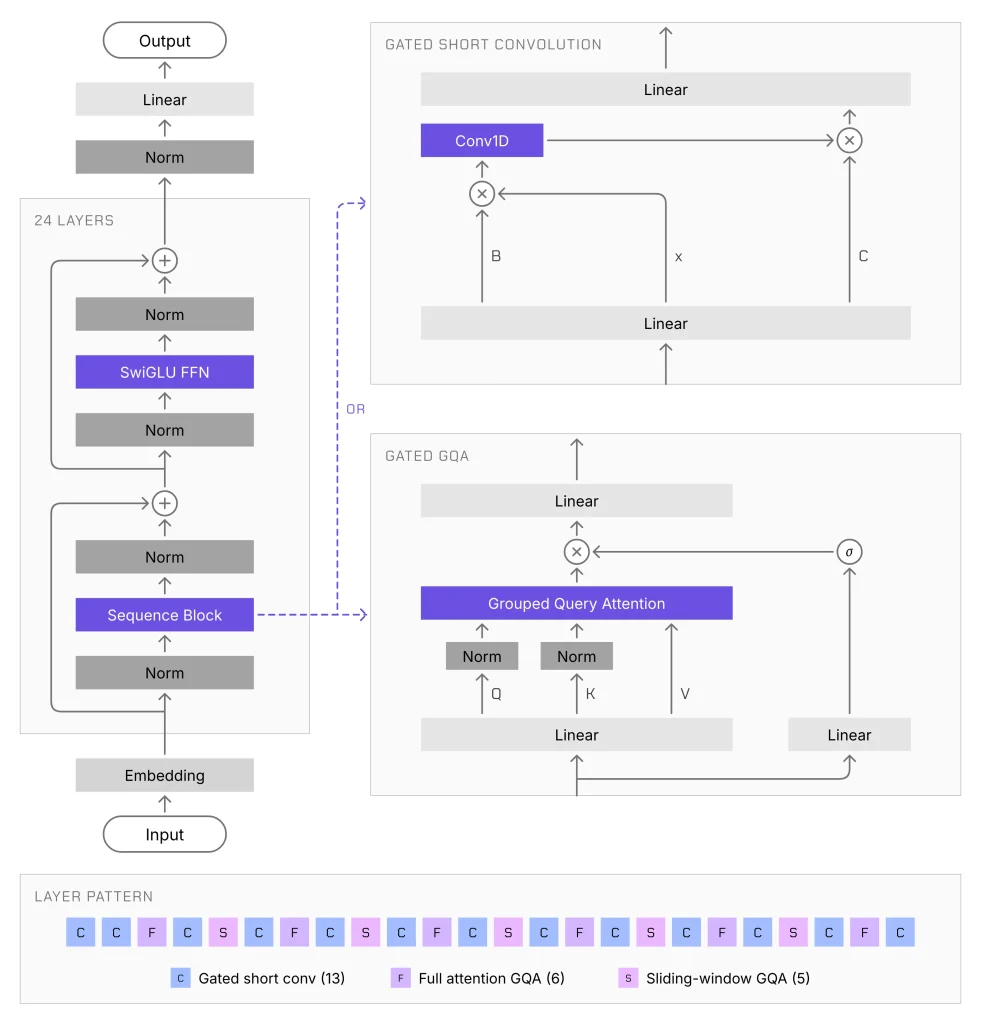
- LFM3-1.7B-Base 采用 24 层 tri-hybrid 架构:13 层门控短卷积、5 层滑动窗口注意力(窗口 256 token)、6 层全局注意力。
- LFM3-1.7B-Base 预训练使用 22T token,最后 3.5T token 为中期训练阶段,上下文窗口扩展至 256K token。
- LFM3-1.7B 在 WebArena-Verified 上得分 38.42,前代 LFM2.5-2.6B 为 3.02;官方称其在浏览器和商业应用的长任务上超过 Qwen3.5-9B。
- LFM3-VL-2B 参数为 1.9B(前代 LFM2.5-VL-3B 为 3.1B),在 62 个视觉基准上的平均分从 57.6 提升至 71.4,官方称与参数量超其六倍的 Gemma 4 12B 持平。
- LFM3-Audio-2B 的语音质量 UTMOSv2 得分为 3.83,前代 LFM2.5-Audio-1.5B 为 3.22;支持 18 种语言。
本站视角
LFM3 最值得关注的不是某个 benchmark 分数,而是它把「多模态」做成了同一骨干上的分支,而不是六个独立模型。这对做端侧 Agent 的团队有直接影响:过去要在设备上同时跑 ASR、VLM、LLM、TTS 四个模型,现在 LFM3-Omni-2B 用一个模型覆盖,内存和调度复杂度都会下降。对国内做私有化部署的中小企业,单卡微调 + 开放权重意味着可以用自己的术语和数据做适配,不必依赖 API。但需要指出的是,Liquid AI 的对比基准多为自家前代或特定测试集,WebArena-Verified 上 38.42 对 3.02 的跃升幅度极大,这类数字应视为厂商自报,缺乏第三方复现;「与 Gemma 4 12B 持平」也是在 62 项基准的平均分上,具体任务表现可能差异很大。另外,2B 级模型在中文长尾任务上的表现、以及 256K 上下文在端侧的实际内存占用,原文均未给出,这是跟进前需要自己验证的部分。我们认为 LFM3 的路线判断是清晰的:不追求通用能力上限,而是把「可微调、可部署、够用」做成产品。它是否成立,取决于开发者能否在单卡上真正微调出可用的专用模型,而不是又一个跑分好看的开源发布。
背景与影响
Liquid AI 此前以 LFM2 系列确立了「短卷积 + 注意力混合」的端侧模型路线,强调在手机、树莓派等设备上低延迟运行。LFM3 的核心变化是把这一路线扩展为多模态统一骨干:先训练一个 1.7B 的基础模型,再为视觉、音频、全模态分别接上自研编码器,而不是为每个模态单独训练大模型。官方称架构搜索覆盖了 14 种设备与后端组合,包括手机、Raspberry Pi 5、笔记本、云 CPU、GPU 和高通 Hexagon NPU。这意味着 Liquid AI 的目标不是与云端大模型正面竞争,而是押注「专用小模型 + 端侧部署 + 单卡微调」的路线。对中文开发者而言,开放权重和单卡微调门槛较低,适合在私有数据上做垂直场景适配;但 2B 级模型的实际能力边界、中文支持程度以及微调后的稳定性,仍需实测验证。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。