ServiceNow 发布 AutoSynthData:为企业 Agent 自动生成训练数据
速览
- 企业 Agent 的短板来自其特定系统、规则与数据状态,通用能力不等于环境适配
- 单个失败案例不足以训练,需要大量在不同情境下考验同一能力的新任务
- AutoSynthData 用能力规格卡指导生成,生成器看不到原始提示、实体与验证器细节
- 生成任务必须可执行、参考解可跑通、验证器能区分成功与失败
- target 阶段并行生成核心样本,multiply 阶段扩展变体以扩大数据规模
- 每个变体拥有独立的用户请求、环境状态、实体配置、参考轨迹与验证器
- 生成控制与环境执行分离,由共享控制器与适配器分别负责
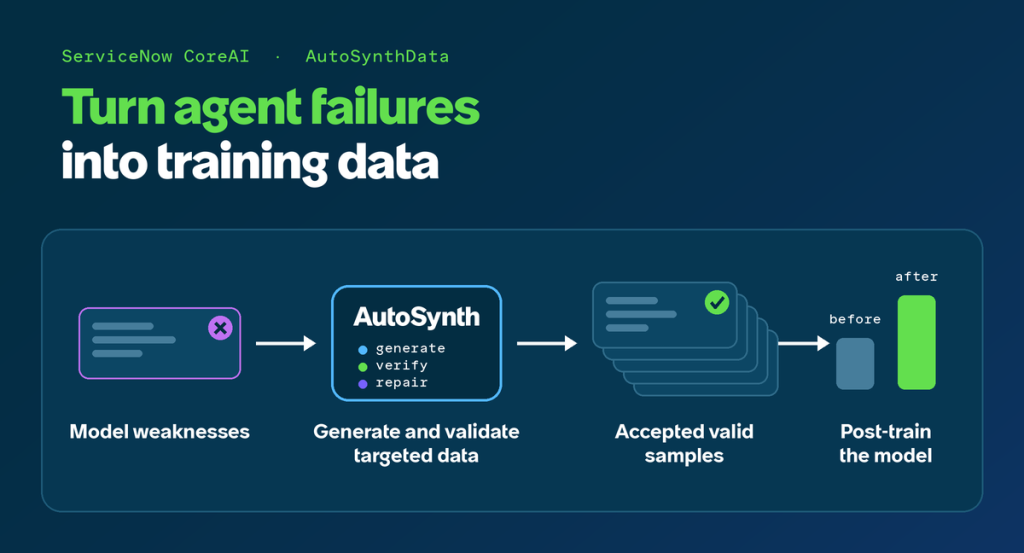
ServiceNow CoreAI 团队在 Hugging Face 博客发布 AutoSynthData,一套把企业 Agent 能力短板转化为训练数据的流水线。它先用诊断任务评估目标模型,并让更强的教师模型在同一批任务上运行,从中提炼出「能力规格卡」,再据此生成新的可执行任务,经校验后用于后训练。团队以 EnterpriseOps Gym(Malay 等,2026)数据集演示该流程。AutoSynthData 将任务抽象为系统规格、用户提示与验证器三部分,要求任务同时满足可行性、真实性与难度;验证器则需具备一致性、可靠性与完备性。数据集分两阶段构建:target 阶段并行生成并校验核心样本,multiply 阶段在已通过样本基础上扩展变体,且变体不能再次作为种子,以限制漂移。样本需通过求解器评估(目标模型三次中最多成功一次、强求解器三次中至少成功两次)、正负验证与有限修复后才被接受。
关键事实
- AutoSynthData 由 ServiceNow CoreAI 团队构建,文章发布于 2026 年 10 月 2 日
- 流水线用目标模型的失败与更强教师模型的成功来决定下一步训练内容
- 任务被抽象为 system specification、user prompt、verifier 三部分
- 任务需满足可行性、真实性与难度三项属性,验证器需满足一致性、可靠性与完备性
- 样本筛选标准为目标模型三次试验中最多成功一次、强求解器三次中至少成功两次
- 数据集分 target 与 multiply 两阶段,multiply 样本不能再次作为种子
为什么值得关注
对做企业 Agent 的团队来说,这套方法提供了一条从评估失败到训练数据的自动化路径,减少人工标注任务的工作量;同时其多重校验机制也提示,合成数据的质量取决于验证器是否可靠,而非生成数量。
背景与影响
企业部署 Agent 时,模型往往在通用基准上表现良好,却在具体工作流、工具组合或策略约束上出错。把这些失败转化为训练数据需要大量可执行、可验证且贴近真实请求的任务,人工构造成本高。AutoSynthData 试图用教师模型与自动化校验把这一过程流水线化,并以 EnterpriseOps Gym 作为演示环境。
本文整理自公开报道,版权归原作者所有;文中观点仅供参考,不代表本站立场。如有版权问题,请联系我们。