ServiceNow 发布 AutoSynthData:用失败案例自动生成企业 Agent 训练数据
来源Hugging Face Blog查看原文
速览
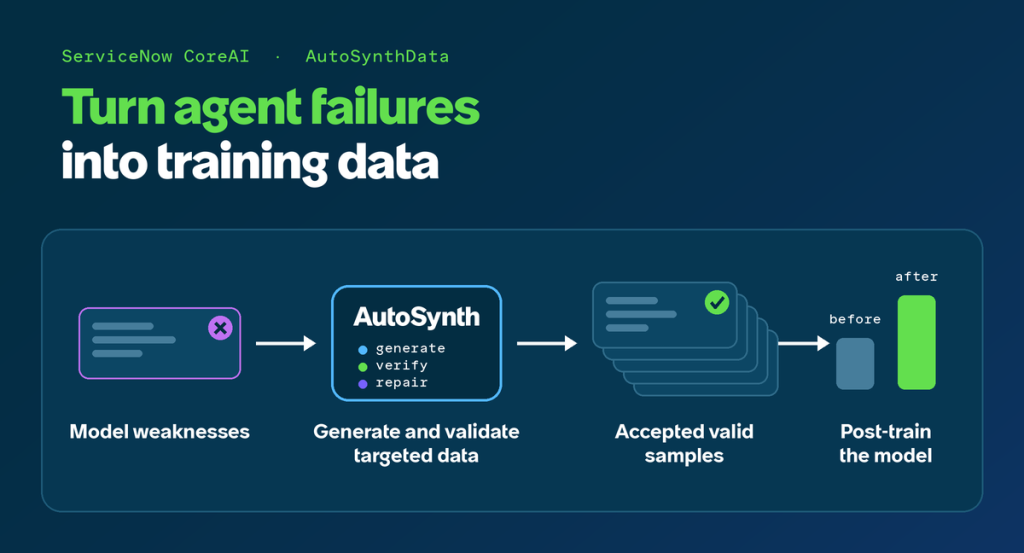
- AutoSynthData 用目标模型的失败和教师模型的成功来定位能力缺口,自动生成新训练任务。
- 任务必须满足可行性、真实性和难度,verifier 需满足一致性、可靠性和完备性。
- 生成分 Target 和 Multiply 两阶段,Multiply 变体不能再次作为种子,以限制漂移。
- 样本级验证包括 solver 评估、正向验证、负向验证和有限次修复。
- 批级别 meta-review 检查任务家族过代表、能力维度缺失和重复模式。
- Hybrid 实验:2000 条样本、18 小时、Pass@1 提升 7.2 个百分点、verifier 成功率升至 68.55%。
- ITSM 实验:1994 条样本、66 小时、Pass@1 从 18.77% 升至 27.18%。
- 当前实验聚焦 SFT,同一机制未来可能支持 RL。
ServiceNow CoreAI 团队在 Hugging Face 博客发布 AutoSynthData,一套面向企业 Agent 的合成训练数据生成流水线。它先用诊断任务找出目标模型的能力缺口,再借助更强的教师模型生成并验证新任务,最后用于后训练。在 EnterpriseOps Gym 的 Hybrid 环境中,用 Gemma-4-26B-A4B-it 作为目标模型、Qwen3.8-27B 作为教师,约 18 小时生成 2000 条训练样本,微调后最佳 checkpoint 出现在第 5 个 epoch,平均 Pass@1 提升 7.2 个百分点(相对提升 35%),verifier 成功率从 63.01% 升至 68.55%,填补了 Gemma 与参考模型之间 59% 的 Pass@1 差距。在 ITSM 环境中,用 Gemma-4-26B-A4B-it 和 DeepSeek-V4.1-Flash,66 小时生成 1994 条样本,平均 Pass@1 从 18.77% 提升到 27.18%。
关键事实
- AutoSynthData 由 ServiceNow CoreAI 团队开发,发布于 Hugging Face 博客,作者包括 Esakkivel Esakkiraja、Shruthan Radhakrishna、Denis Akhiyarov、Sagar Davasam。
- 该方法将任务抽象为 system specification、user prompt、verifier 三部分,要求任务满足可行性、真实性和难度三个属性。
- 生成流程分两阶段:Target 阶段生成核心样本,Multiply 阶段基于已接受样本扩展变体,且变体不能再次作为种子。
- 每个候选任务需通过 solver 评估、正向验证、负向验证和有限次修复,批级别还有 meta-review 检查覆盖度与多样性。
- Hybrid 实验:目标模型 Gemma-4-26B-A4B-it,教师模型 Qwen3.8-27B,约 18 小时生成 2000 条样本,最佳 checkpoint 为 epoch 5。
- Hybrid 结果:平均 Pass@1 提升 7.2 个百分点(相对提升 35%),verifier 成功率从 63.01% 升至 68.55%,填补 59% 的 Pass@1 差距。
本站视角
对国内做企业 Agent 的团队来说,AutoSynthData 提供了一条可复用的思路:不必从零标注数据,而是用「失败驱动 + 教师示范 + 环境验证」的闭环来生成训练样本。这直接影响到需要为金融、政务、客服等垂直场景微调模型的公司——它们通常缺少高质量的任务数据,却拥有可执行的环境和明确的成功标准。我们认为,这套方法真正的价值不在于生成多少条数据,而在于把「模型哪里不行」变成可操作的课程,并且用 verifier 把住质量关,避免合成数据常见的「看起来合理但不可执行」问题。与单纯用大模型批量造数据相比,它更强调任务在环境中的可执行性和验证的可靠性,这是企业场景的硬约束。不过,原文的实验只覆盖 EnterpriseOps Gym 的两个环境,且目标模型和教师模型均为特定组合,提升幅度能否迁移到其他模型、其他工具链,需要更多独立复现。另外,66 小时生成 1994 条样本的 ITSM 实验说明生成成本并不低,对中小团队而言,教师模型的调用开销和工程复杂度可能成为落地门槛。我们建议关注其后续在 RL 上的测试,以及是否开源完整流水线——如果只停留在论文和博客层面,对中文开发者的直接帮助有限。
背景与影响
企业部署 Agent 时,模型往往在通用基准上表现不错,却难以适应特定环境的工作流、工具组合和约束。传统做法是人工构造训练数据,但成本高、覆盖窄,且难以针对模型的具体弱点。ServiceNow CoreAI 提出的 AutoSynthData 试图把「模型失败」转化为「训练课程」:先评估目标模型在环境中的表现,识别它反复失败的能力维度,再让更强的教师模型生成可执行、可验证的新任务,并给出成功轨迹用于监督微调。随着模型改进,生成目标会向仍难解决的任务移动,形成动态课程。这一思路与近期业界对合成数据、Agent 训练和自动课程学习的关注一致,但企业级环境对任务可行性、真实性和验证可靠性的要求更高,AutoSynthData 在流程中加入了多道质量门和批级别审查。需要观察的是,该方法在更复杂、多步骤的企业工作流中能否保持同样的提升幅度,以及教师模型的能力上限是否会成为瓶颈。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。