微软发布 Skala 1.1,并集成到 CP2K 等主流计算化学软件
来源Microsoft Research查看原文
速览
- Skala 1.1 训练数据量翻倍,精度显著提升。
- GMTKN55 误差 2.8 kcal/mol,超越领先杂化泛函。
- 已集成到 CP2K,并正在整合进 Psi4、FHI-aims、ORCA、VASP。
- 推出持续更新的性能基准,跟踪优化进展。
- CPU/GPU 性能与 meta-GGA 相当,大分子开销消失。
- 采用持续改进范式,每个版本取代前版,而非累积。
- 训练数据来自扩展的 MSR-ACC 数据集,新增电子亲和能和非共价簇。
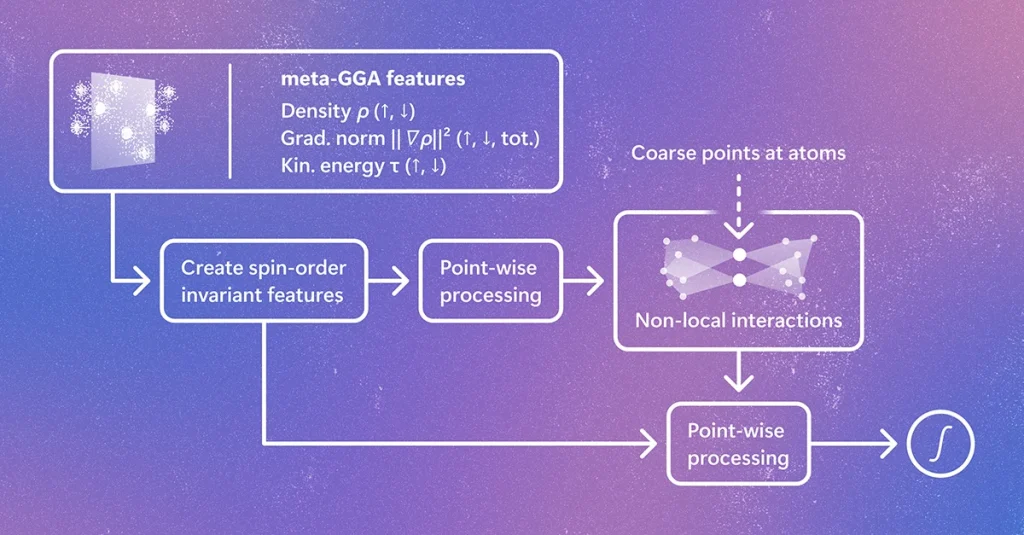
微软研究院发布深度学习交换关联泛函 Skala 1.1,训练数据量是初版的 2.5 倍,在 GMTKN55 基准上加权平均误差为 2.8 kcal/mol,精度超过当前领先的全局杂化泛函,同时保持半局域泛函的效率。Skala 已集成到开源软件 CP2K,并正在整合进 Psi4、FHI-aims、ORCA 和 VASP。微软同时推出一个持续更新的性能基准报告,跟踪后续优化版本的性能表现。
关键事实
- Skala 1.1 训练数据量是初版 Skala 的 2.5 倍。
- 在 GMTKN55 基准测试中,Skala 1.1 的加权平均误差为 2.8 kcal/mol。
- 该精度超过当前领先的全局(范围分离)杂化泛函,同时保持半局域泛函的计算效率。
- Skala 已集成到开源 CP2K 软件包,与 CASUS 团队 Thomas D. Kühne 教授合作完成。
- 正在整合进 Psi4、FHI-aims、ORCA 和 VASP。
- 微软发布了一个持续更新的性能基准报告和测试工具,跟踪 Skala 在不同软件包和硬件平台上的性能。
本站视角
对中文计算化学和材料模拟研究者而言,Skala 1.1 的发布意味着他们可以在 CP2K 等常用软件中直接使用这一高精度泛函,无需切换到陌生的平台。这降低了采用门槛,可能推动国内相关团队在催化、电池材料等领域的模拟精度提升。从行业格局看,微软通过持续改进和广泛集成,正在挑战传统泛函的碎片化生态,若其精度和效率优势在实际应用中得到验证,可能改变计算化学软件内置泛函的竞争态势。需要观察的是,2.8 kcal/mol 的误差虽优于杂化泛函,但距离化学精度(约 1 kcal/mol)仍有差距,且其泛化能力在训练数据未覆盖的体系上尚待检验。此外,微软主导的基准报告虽强调透明,但由开发方自行维护,独立第三方验证的缺失可能影响社区信任度。对于国内做 DFT 方法开发的团队,Skala 的成功也提示了深度学习与第一性原理结合的巨大潜力,值得跟进其技术路线。
背景与影响
密度泛函理论(DFT)是计算化学和材料科学的核心工具,但传统泛函在精度和效率之间难以兼顾。微软研究院此前推出了基于深度学习的交换关联泛函 Skala,旨在实现预测性精度。Skala 采用持续改进策略,每个新版本取代旧版,而非像传统泛函那样不断累积。此次发布的 Skala 1.1 是这一范式的首次展示,通过扩大训练数据集 MSR-ACC,提升了热化学、反应动力学和分子结构预测等任务的精度。同时,微软积极与电子结构软件社区合作,将 Skala 集成到主流软件中,以降低使用门槛。这意味着计算化学家可以在日常使用的工具中直接获得更高精度的模拟结果,可能加速药物发现、催化、能源材料等领域的研究。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。