微软开源逆合成模型 RetroChimera,登上 Nature
来源Microsoft Research查看原文
速览
- 微软在 Nature 发表逆合成模型 RetroChimera,并开源实现与权重。
- 模型由 R-SMILES 2 与 NeuralLoc 两个互补子模型集成而成。
- R-SMILES 2 灵活但易幻觉,NeuralLoc 可靠但受模板库约束。
- 学习式集成按名次投票,兼顾常见与罕见反应类别。
- 盲测中博士级化学家更偏好其预测,胜过既有方法与文献反应。
- 论文验证了罕见反应召回、零样本迁移与专有数据微调。
- 模型以 MIT 许可开源,并通过 Microsoft Foundry 提供访问。
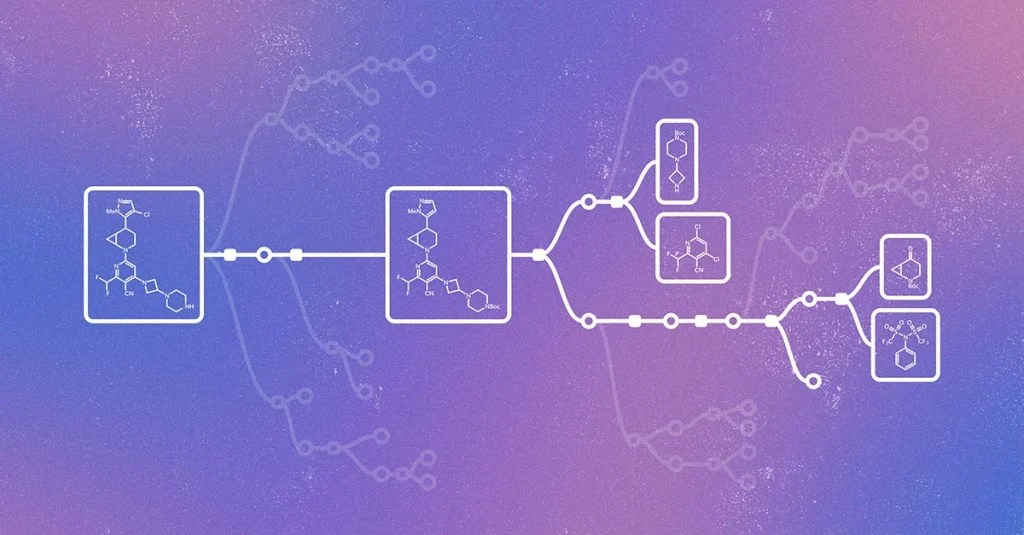
Microsoft Research 在 Nature 发表逆合成预测模型 RetroChimera,并开源其实现与权重(MIT 许可),同时通过 Microsoft Foundry 提供访问。该模型由两个子模型组成:基于 Transformer 的 de-novo 模型 R-SMILES 2,以及基于图神经网络(GNN)的模板选择模型 NeuralLoc。两者预测模式互补,RetroChimera 通过学习式集成策略对二者的排序预测进行投票合并,从而在常见与罕见反应类别上均表现良好。在盲测中,博士级化学家更偏好 RetroChimera 给出的单步反应预测,优于其两个子模型、更成熟的既有方法,甚至优于文献中记录的反应。微软希望该模型能加速药物与先进材料领域的新分子研发。
关键事实
- RetroChimera 的论文已发表在期刊 Nature 上,包含架构描述与大量验证研究。
- 模型由两个子模型构成:基于 Transformer 的 de-novo 模型 R-SMILES 2,以及基于 GNN 的模板模型 NeuralLoc。
- R-SMILES 2 直接由输入分子预测前体分子,灵活但易产生幻觉;NeuralLoc 将目标分子与反应模板编码为图,输出更可靠但受模板库限制。
- RetroChimera 采用学习式集成策略,按排序为每个预测反应物集合分配依赖名次的投票,两模型提出相同反应时票数相加。
- 论文报告了模型召回罕见反应类型的能力,以及在专有数据集上的零样本迁移与微调成功。
- 在盲测中,博士级化学家更偏好 RetroChimera 的单步反应预测,优于其子模型、更成熟的既有方法以及测试集本身记录的文献反应。
本站视角
对做药物发现与材料研发的团队来说,逆合成规划是长期卡点:它既依赖稀缺的资深合成化学家,又直接推高研发成本。RetroChimera 的价值不在于又发了一个模型,而在于两点:一是它把「罕见反应召回」和「分布外鲁棒性」这两个实际痛点作为验证重点,并给出了盲测中化学家偏好度超过文献反应的证据;二是它选择开源权重(MIT 许可)并接入 Microsoft Foundry,这意味着中小型药企、AI for Science 创业公司和高校课题组不必自建大规模反应数据集就能直接试用。我们认为,这类工具真正的分水岭在于能否被化学家在日常工作中采纳,而盲测偏好度是比 benchmark 分数更贴近实际的信号。需要观察的是:论文中的盲测规模与化学家样本量原文未披露,偏好度结论的统计强度尚不明确;「优于文献反应」这一说法也可能受测试集选取方式影响。此外,模型在专有数据上的微调表现由微软自身报告,缺乏第三方复现。对国内做 AI 制药的团队而言,这既是一个可直接集成的基线,也是一个提醒:数据与模板库的覆盖度仍是拉开差距的关键,而非单纯的模型架构。
背景与影响
新药与新材料研发依赖新分子的合成,但合成路线规划长期依赖人工,耗时且成本高昂,是药物开发成本的重要来源。逆合成方法从目标分子出发,逐步拆解为更简单的前体,类似棋类博弈中的搜索,但可能的「走法」数量远多于棋盘游戏,且对给定分子而言哪些反应可行并不明确。现有系统面临三大挑战:召回罕见但战略上重要的反应、在训练分布之外的鲁棒性,以及与化学家判断的对齐。RetroChimera 通过组合两个互补模型来应对这些问题。微软表示,该模型有望帮助研究者更高效地识别有前景的合成路线,加速「设计—合成—测试」循环,并在实验室自动化配合下,推动合成规划与执行走向闭环、自我改进的系统。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。
