AI 为什么突然擅长数学了:从 Erdős 单位距离猜想到 Navier-Stokes,LLM 的深度优先搜索与验证器机制
来源Latent Space查看原文
速览
- 问题难度可用最短提示序列长度 k 与步间工作量 t 来近似,复杂度随 k 指数增长
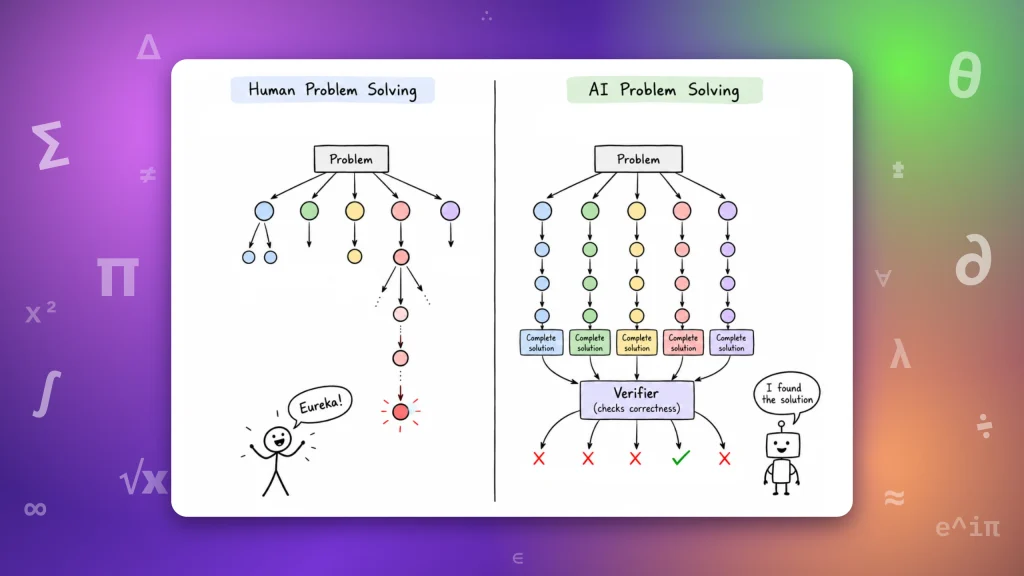
- 人类做广度优先搜索,因为验证一个方向要花数月,所以对提示质量要求极高
- LLM 做深度优先搜索,配合验证器几分钟内即可判定一条路径是否可行
- drafter / solver / verifier 三段式 harness 把失败路径转化为负向提示
- 模型优势在于「概念跳跃已完成、剩下繁重数学」的问题
- 人类优势可能在搜索树深、分支多、需要严格剪枝的问题
- 失败的信息量与其背后的确信程度成正比,但 AI 的失败过程很少被公开
- Tao 认为证明只是发展理解的代理,只公布最终解是误把终点当旅程
Latent Space 这篇文章试图回答一个问题:LLM 在数学上的突破能否被预测,什么样的数学问题对模型来说是可解的。文章梳理了 2025 年的一系列事件:5 月 OpenAI 的内部模型找到 Erdős 单位距离猜想(1946 年提出)的反例,6 月发布 Cycle Double Cover(CDC)问题的证明,7 月又解决十个开放问题,9 月给出 Navier-Stokes 的证明;Anthropic 则完成了费马大定理的形式化,并在黎曼猜想上取得更强的界。作者借用数学家 WT Gowers 的框架,把问题难度定义为「让专家重建证明所需的最短提示序列长度 k」加上「每步之间的工作量 t」,复杂度约按 2^k + t 增长。人类研究是广度优先:先浅尝多个方向,再押注少数几个,因为验证一个方向往往要花几个月,所以对提示质量的要求极高。LLM 则是深度优先:拿到一个提示就一路推到底,配合并行 agent 和自动验证器剪枝,几分钟内就能知道一条路走不走得通,于是「提示质量」的门槛几乎消失。文章还拆解了 drafter / solver / verifier 三段式 harness,并以 CDC 的 prompt 为例,说明失败路径如何被写成负向提示。结论是:模型擅长的是「概念跳跃已经完成、剩下的是繁重复杂数学」的问题,也就是 k 和分支因子 b 都不大的问题;人类仍可能在搜索树深且分支多、需要严格剪枝的问题上保有优势。
关键事实
- 5 月 OpenAI 内部模型找到 Erdős 单位距离猜想的反例,该猜想自 1946 年提出以来一直开放
- 6 月 OpenAI 发布 Cycle Double Cover(CDC)问题的证明,7 月又给出另外十个开放问题的解,9 月发布 Navier-Stokes 的证明
- Anthropic 发布了费马大定理的形式化,并在黎曼猜想上取得更强的界
- Gowers 提出的复杂度公式为 2^k + t,k 是最短提示序列长度,t 是展开提示所需的工作量
- OpenAI 的 Navier-Stokes 证明共 166 页,动用了 10,000 个 agent,88 小时内消耗 300B tokens
- 数学家 Jacob Tsimerman 曾研究单位距离猜想的反例方向,但中途放弃,近期被 OpenAI 聘用
本站视角
这篇文章的价值不在于复述「AI 又解了几个数学难题」,而在于给出了一个可操作的判断框架:一个问题对 LLM 是否可解,取决于概念跳跃的次数 k 和每步的分支因子 b,而不是取决于问题在人类眼中的「难度标签」。这对几类人有直接影响。第一类是做 AI for Science 的团队:如果按 b^k × 计算成本来挑选问题,就应该优先找那些「大方向已定、剩下的是繁重推导」的课题,而不是追求需要全新概念框架的问题;文章里 Navier-Stokes 证明动用 10,000 个 agent、88 小时、300B tokens 的数字,也提示这类工作的成本结构已经接近工程项目而非研究项目。第二类是数学研究者:Tsimerman 的经历说明,人类放弃一条路径往往不是因为能力不足,而是因为洞察类问题没有进度梯度,几个月看不到反馈就会耗尽士气;模型恰好没有这个约束,这意味着「人类提出方向、模型跑完全程」的分工可能比「模型独立发现方向」更早落地。第三类是关注 AI 能力评估的读者:文章提醒,实验室有动机挑选解空间窄的问题来展示模型能力,因为这类问题更容易做出漂亮结果;因此看到「AI 证明某猜想」的新闻时,应先问这个问题的分支因子有多大、概念跳跃有几个,而不是直接外推到「AI 将独立做出广义相对论」。我们认为文章对「LLM 能否自己提出广义相对论」的乐观判断需要打折扣:作者自己也承认,把引力视为几何这个提示极其反直觉,CoT 只有在穷尽其他所有路径后才可能落到它上面,而「穷尽」的前提是验证器能判断每条失败路径为何失败,这在物理学中远不如在形式化数学中清晰。另一个值得警惕的点是,文章的核心案例(单位距离反例、CDC、Navier-Stokes)都来自 OpenAI 和 Anthropic 的自我披露,外部独立复核的细节有限,166 页证明和 300B tokens 这类数字目前只有单一来源。最值得跟进的是作者提出的那个分歧:AI 的失败路径几乎不公开,而失败中的信息恰恰是数学社区最需要的;如果实验室只发布最终证明,人机互补就只完成了一半。
背景与影响
这篇文章的背景是 2025 年 AI 在数学领域的密集产出。长期以来,数学被视为 LLM 最难攻克的领域之一,因为形式化证明需要长链条的严格推理,而模型容易在中途产生看似合理实则错误的步骤。文章提到的转折点来自三项能力叠加:模型更擅长串联长程任务中的基础操作(降低 t)、具备自我验证能力(能在轨迹内部发现错误步骤,OpenAI 专门用大规模真实案例训练了数学验证)、以及编排能力(指挥子 agent、用记忆剔除错误路径)。作者用 Gowers 的框架解释这一变化,并引入分支因子 b 的概念:每一步有 b 个合理提示,k 步就有 b^k 条路径。人类靠品味和判断把有效 b 压得很小,AI 则必须几乎穷举每一条合理分支,但速度快。这意味着模型会在 b^k × 计算成本较小的领域先取得突破。作者还讨论了人机互补:人类擅长缩小分支,模型擅长缩短剪枝一条分支所需的时间。文章最后引用了 Terence Tao 的观点,认为数学的深层目的是发展理解,而不仅是产出证明。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。

