普林斯顿团队发布 AI Agent 评测趋势论文:33 个新兴趋势,单基准评测成本可达数万美元
来源AI Snake Oil查看原文
速览
- Agent 评测需审视完整执行轨迹,不能只看最终结果
- 评测成本高企:单基准可达数万美元额度,另需大量工程投入
- 评测结果无法跨层级迁移,实验室能力不等于真实场景收益
- METR 试验显示 Agent 工具反而拉长了软件开发任务完成时间
- 自动化与增强是两种互补视角,当前评测偏重前者
- 独立评测受制于资金、模型访问权限与思维链透明度
- 评测工具自身也需被评测,存在局限与偏差
- 论文呼吁多学科参与,并提升评测的有效性与严谨性标准
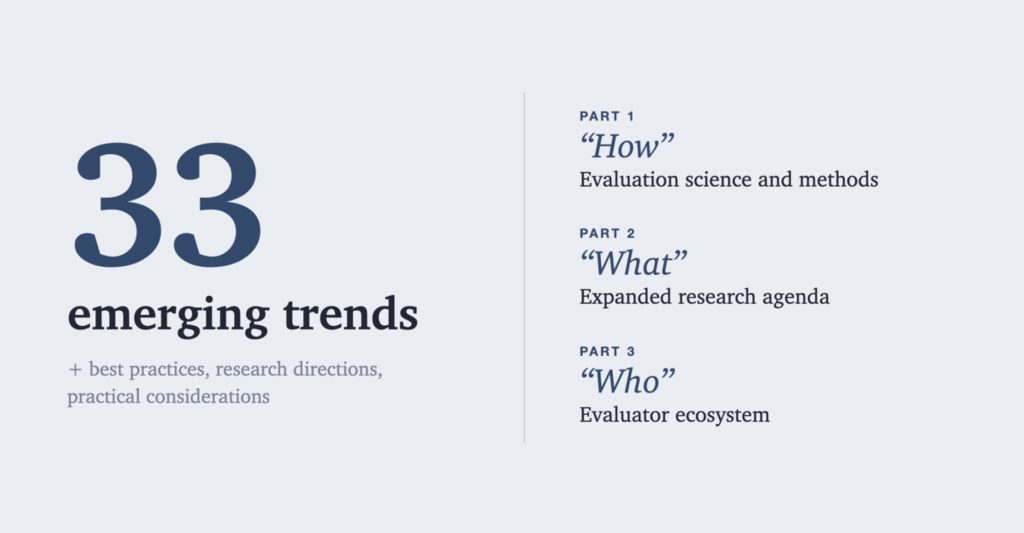
普林斯顿大学研究团队(Felix Chen、Stephan Rabanser、Sayash Kapoor、Arvind Narayanan 等)联合 Stanford、英国 AI Security Institute、Brookings 的评测研究者,发布论文《Emerging Trends in AI Agent Evaluation》,从科学方法、研究议程、评测生态三个维度梳理出 33 个新兴趋势。论文的核心判断是:Agent 评测比模型评测复杂得多——评测者必须审视整条执行轨迹而非只看最终结果,要判断 Agent 是否走了捷径,也更难把性能变化归因到 Agent 的具体组件。成本正在成为门槛:ExploitBench 上多个 Agent 的评测消耗了数万美元的额度,且不含搭建和维护评测基础设施的工程投入。论文还指出评测结果无法跨层级迁移(METR 的随机对照试验发现,使用 Agent 工具反而增加了软件开发任务的总体完成时间),并讨论了谁能参与评测、独立性的资金来源与模型访问权限(前沿实验室现在只发布摘要版思维链而非原始轨迹)等生态问题,最后分别对潜在评测者、现有评测者、资助方、榜单聚合方、企业部署方、实验室和政策制定者给出建议。
关键事实
- 论文题为《Emerging Trends in AI Agent Evaluation》,作者包括 Felix Chen、Stephan Rabanser、Sayash Kapoor、Arvind Narayanan,合作方来自 Stanford、英国 AI Security Institute 和 Brookings
- 论文梳理出 33 个 AI Agent 评测的新兴趋势,覆盖科学方法、研究议程、评测生态三个维度
- 普林斯顿该研究组在 AI Agent 评测方向已投入约三年(可追溯至 arXiv:2407.01502)
- ExploitBench 基准上多个 Agent 的评测花费达数万美元的额度,且未计入搭建与维护评测基础设施的工程成本
- METR 的随机对照试验发现,使用 Agent 工具进行软件开发反而增加了任务的总体完成时间
- 前沿实验室现在只发布摘要版思维链(Chain of Thought)而非原始轨迹,影响独立评测者评估真实前沿的能力
本站视角
这篇论文最直接的影响对象是做 Agent 产品的团队和企业内部的 AI 平台部门。过去两年,厂商习惯用 benchmark 分数证明 Agent 能力,采购方也习惯看分数做决策;论文明确指出这种证据链在 Agent 时代不成立——轨迹里可能藏着捷径,性能变化难以归因,实验室能力也未必迁移到具体业务场景。这意味着国内做 Agent 的团队如果继续拿通用榜单分数做对外宣传,遇到懂行的客户会越来越难说服,需要补的是场景内的端到端评测。 第二个受影响的是独立评测者和做榜单的机构。论文点出的成本与访问权限问题值得国内警惕:当评测成本上升到数万美元量级,且前沿实验室只给摘要版思维链,独立评测的可信度就取决于资金和关系,而不是方法。我们认为这是论文里最实质的判断,也是它区别于一般「评测很重要」呼吁的地方——它把评测的独立性问题还原成了资源问题。 需要指出的是,这篇是立场明确的议程设置型论文,不是实证研究。33 个趋势是作者基于自身经验和社区观察的归纳,没有给出趋势的量化依据或筛选标准;METR 的随机对照试验被引用为「能力不迁移」的证据,但那是特定任务、特定工具条件下的结果,论文没有讨论其外部有效性。另外,作者团队本身处于评测生态之中,论文对「扩大评测者队伍」「增加评测资助」的呼吁,与其自身立场存在利益相关性,读者应把建议部分当作倡议而非结论。
背景与影响
AI Agent 的评测正成为行业瓶颈。过去模型能力主要靠 benchmark 分数说话,但 Agent 具备工具调用和环境交互能力,行为链条长、变量多,单一分数很难支撑「真实世界表现」的宣称。论文提出的 33 个趋势本质上是对这一困境的系统化整理:一方面评测方法要从结果导向转向轨迹导向,另一方面评测的组织形态(谁出钱、谁能拿到模型、谁能独立发布结论)也在重塑结果的可信度。值得注意的是,论文点出的成本问题可能带来结构性后果——如果一次前沿 Agent 评测需要数万美元额度加大量工程投入,那么只有大公司和受资助机构才玩得起,独立评测的多样性会被压缩。METR 的随机对照试验则提醒行业:实验室里的能力提升,未必转化为真实工作流中的效率提升,这对当前大量以「Agent 提效」为卖点的产品叙事是一个直接的反证。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。