NVIDIA 用 Nemotron 3 微调出 IOI 与 IMO 双金牌级系统,公开模型、数据集与推理流程
来源Hugging Face Blog查看原文
速览
- 同一 Nemotron 3 基础模型经微调后,在 IOI 与 IMO 两个不同能力域均达金牌水平
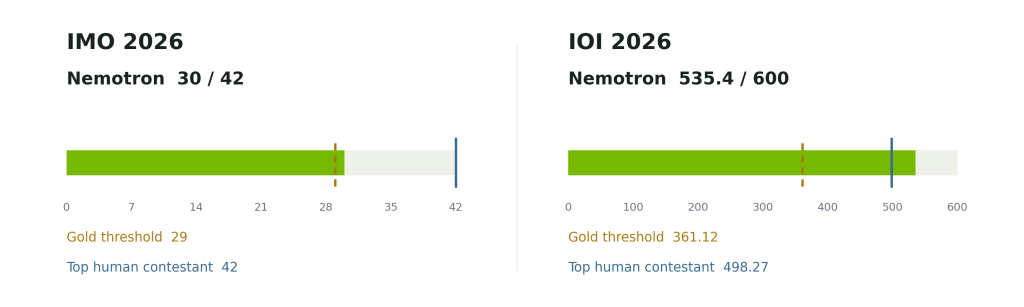
- IOI 得分 535.4/600,远超 361.12 金牌线与 498.27 人类最高分
- IMO 得分 30/42,超过 29 的金牌线,六题中四题满分
- 成绩来自模型、数据与推理循环的协同设计,而非单纯微调或暴力采样
- IOI 用 GenCorrect 迭代生成-评估-改进,把微调收益放大
- IMO 用 SFT 与 RL 互补检查点,优于单检查点多次采样
- Nano 的增益主要来自 SFT,RL 带来较小但稳定的提升
- Ultra 仅一个 SFT epoch 即超过完全后训练的 Nano
- NVIDIA 开源检查点、数据集、基准与推理流程,强调可复现
NVIDIA 在 Hugging Face 博客中公布,其团队以 Nemotron 3 为基础模型,通过监督微调(SFT)、强化学习(RL)与反馈驱动的推理流程,分别打造出在 IOI 2026 与 IMO 2026 达到金牌水平的专用系统。IOI 方向使用 Nemotron-3-Ultra-CC 配合 SFT 与 GenCorrect,得分 535.4/600,高于 361.12 的金牌线,也高于人类最高分 498.27;该测试是在与人类选手相同的时间、联网与提交限制下进行的实时前瞻性运行,但属于非官方、无监督的基准,未计入 IOI 官方排名。IMO 方向使用 Nemotron 3 Ultra 的通用、SFT 与 RL 检查点组成 generate-verify-refine 系统,得分 30/42,超过官方金牌线 29,提交的证明由官方 IMO 评分员批改。NVIDIA 同时开源了 IMO 的 SFT 与 RL 检查点、两份训练数据集、200 道奥赛级题目的 Nemotron-IMO-Bench 基准,以及 IOI 的 Nemotron-3-Ultra-CC 模型、论文与 NeMo-Skills 推理流程。
关键事实
- IOI 2026 方向:Nemotron-3-Ultra-CC 结合 SFT 与 GenCorrect 得分 535.4/600,金牌线为 361.12,人类最高分为 498.27
- IOI 测试为实时前瞻性运行,时间、联网与提交限制与人类选手一致,但属非官方无监督基准,未计入官方排名
- IMO 2026 方向:Nemotron 3 Ultra 的通用、SFT 与 RL 检查点组成 generate-verify-refine 系统,得分 30/42,官方金牌线为 29,六题中四题满分
- IMO 系统提交的证明由官方 IMO 评分员批改,全程使用自然语言,无形式化证明器、外部工具或联网
- IOI 训练使用 22,000 道题与合成推理轨迹,训练出 Nemotron-3-Nano-CC(300 亿总参数、30 亿激活参数,SFT+RL)与 Nemotron-3-Ultra-CC(5500 亿总参数、550 亿激活参数,仅 SFT)
- IOI 2025 上 Nano 从后训练前 130 分提升至 SFT 后 280 分、RL 后 291 分,加 GenCorrect 后达 468 分,越过 438.3 的金牌线;Ultra-CC 用同样测试时策略达 502 分
本站视角
对中文开发者与做 Agent、代码生成、数学推理的团队来说,这件事的实质价值不在两块「金牌」,而在 NVIDIA 把配方、检查点、数据集和推理管线一起放了出来。具体影响几类人:一是做竞赛级代码与数学推理的团队,可以直接用 Nemotron-3-Ultra-CC 和 NeMo-Skills 的 GenCorrect 流程做基线,省掉从零搭评测与迭代框架的成本;二是用 API 做推理服务的中小企业,Nemotron-3-Nano-CC 的 30 亿激活参数、Ultra-CC 的 550 亿激活参数给出了不同成本档位的选择,尤其是「Ultra 一个 SFT epoch 就超过完全后训练的 Nano」这一条,说明在强基座上加少量领域数据可能比在小模型上堆后训练更划算;三是研究推理时计算的团队,IMO 用 SFT 与 RL 互补检查点优于单检查点多次采样,是一个可直接复用的工程结论。我们的判断是:这是实质进步而非纯营销,因为开源了数据、检查点与可复现流程,且 IMO 证明由官方评分员批改,可信度高于自评。但需要指出两点可疑之处:IOI 成绩是 NVIDIA 自己组织的非官方、无监督基准,虽声称与人类选手同条件,仍缺乏第三方复核,535.4 与人类最高分 498.27 的对比不宜直接当作「超越人类」的结论;IMO 的 30/42 是在特定题目集与高算力选优流程下取得,未披露推理成本,实际部署的经济性存疑。对国内团队而言,值得跟进的是那套「专用化四步配方」和 GenCorrect 的迭代机制,而不是分数本身。
背景与影响
IOI 考察算法与代码在严格时间与提交限制下通过隐藏测试的能力,IMO 要求严谨的自然语言证明,两者技能差异明显,同时取得金牌级成绩说明基础模型具备跨域可适配性。NVIDIA 此前在 IOI 2025 的 Hugging Face 文章中已展示测试时计算可把开放权重模型推到金牌水平,本次结果补充了「更好的专用化」这一环:微调让推理系统拥有更好的候选、批评与改进能力。从公开信息看,NVIDIA 把可复用的专用化配方归纳为四步——强基础模型、领域问题与高质量推理轨迹、标准后训练方法(SFT,必要时 RL)、以及生成-评估-改进的推理循环,并强调无需为每个挑战重建基础模型。这意味着对做数学与代码推理的团队而言,可复现的配方与开源资产可能比单次成绩更有价值;同时需要观察的是,IOI 成绩为非官方无监督基准,IMO 虽由官方评分员批改但仍是特定题目集下的结果,其泛化性与成本效率尚待第三方验证。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。
