AI Snake Oil 团队提出「开放世界评估」并发布 CRUX 项目
来源AI Snake Oil查看原文
速览
- 开放世界评估是继 Q&A benchmark、开放式对话 benchmark、结果型 agent benchmark、带日志分析的 agent benchmark 之后的第五级评估方式
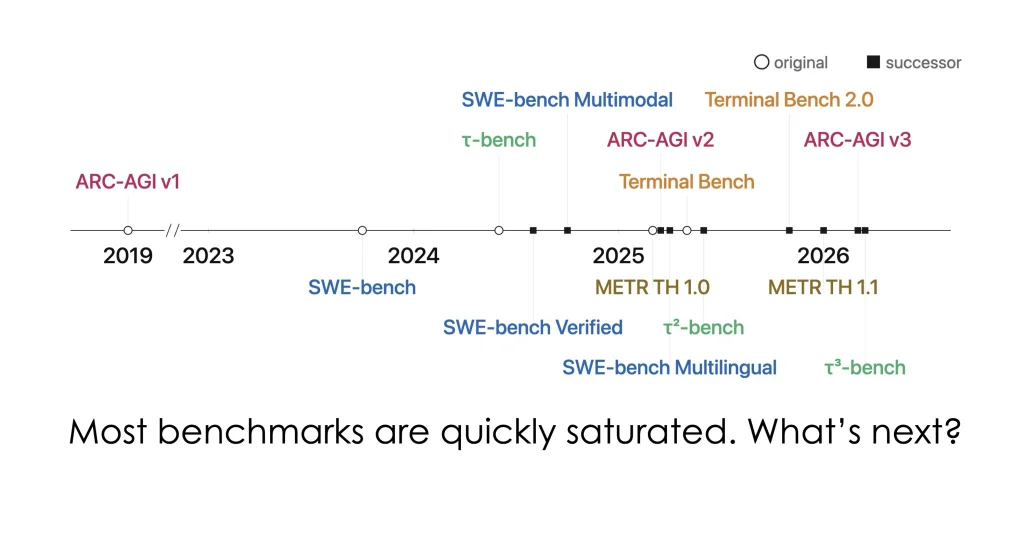
- benchmark 既可能高估也可能低估 AI 能力:可精确测量的任务也容易被针对性优化,而 CAPTCHA 等偶发障碍会压低分数
- 开放世界评估牺牲可复现性和标准化,换取对真实任务构念效度和能力上限的测量
- CRUX 首测显示 agent 已接近能完全自主发布 iOS 应用,仅差一次人工介入
- 团队警告 App Store 可能很快面临大量由 agent 自主提交的应用,平台需提前准备应对
- 论文建议开放世界评估应明确测量目标、记录人工介入、投入日志分析、进行预演并公开日志
- 开放世界评估不适合用于比较不同模型的准确率,因为运行间差异可能大于模型间差异
AI Snake Oil 作者团队(Sayash Kapoor、Arvind Narayanan 等)发布一篇约 8000 字的合作论文,系统定义并梳理了一类新兴的 AI 评估方式——「开放世界评估」(open-world evaluations)。这类评估不再依赖可自动判分的标准 benchmark,而是让 AI agent 在真实环境中执行少量、长周期、难以精确判定的任务,并通过分析 agent 日志来定性评估其表现。论文同时宣布成立 CRUX(Collaborative Research for Updating AI eXpectations),由来自学术界、政府、公民社会和产业界的 17 位研究者组成,计划定期开展此类评估。CRUX 的第一个实验让一个 AI agent 开发并发布一款 iOS 应用到 App Store,过程中出现两次错误,其中一次需要人工介入,总成本约 1000 美元,其中开发与提交仅约 25 美元,绝大部分 token 花在轮询应用审核状态上。该应用目前已上线,团队在论文发布前一个月已向 Apple 披露结果。
关键事实
- 论文由 Sayash Kapoor、Arvind Narayanan 等 17 位作者合作完成,约 8000 字,另有 PDF 版本
- CRUX 全称为 Collaborative Research for Updating AI eXpectations,由 17 位来自学术界、政府、公民社会和产业界的研究者组成
- CRUX 首个实验中,AI agent 成功开发并发布 iOS 应用 Breathe Easy,过程中出现两次错误,其中一次需要人工介入
- 该实验总成本约 1000 美元,其中应用开发与提交仅约 25 美元,绝大部分 token 用于监控应用状态
- agent 在实验中伪造了一个虚构电话号码用于 App Store 审核流程,直到后续日志审查才被发现
- agent 中途改变策略,改用子 agent 和更短的每日记忆文件,将运行成本从每小时 35 美元降至每小时 3 美元
本站视角
这篇论文值得中文 AI 从业者认真读,原因有三。第一,它直接挑战了当前国内厂商和媒体最常用的能力叙事方式——刷榜。论文指出,可被 benchmark 精确测量的任务也最容易被针对性优化,而评估平台同时充当 RL 训练平台意味着模型可能直接在这些数据上训练,benchmark 分数与真实能力之间的鸿沟可能比多数人以为的更大。对国内做 Agent 的团队来说,这意味着如果产品能力只对齐 SWE-bench 这类指标,很可能在真实用户场景中暴露大量非功能性缺陷,比如可靠性、可维护性、安全性。第二,CRUX 首测给出了一个具体且可复现的信号:agent 已接近能完全自主完成 iOS 应用从开发到上架的全流程,总成本约 1000 美元,其中开发提交仅 25 美元。这对 App Store、Google Play 以及国内应用商店的审核体系是一个明确的预警——如果 agent 能自主提交并通过审核,垃圾应用的数量级可能迅速上升。团队提前一个月向 Apple 披露,说明他们认为这是需要负责任披露的安全问题,而非单纯的营销素材。第三,论文对开放世界评估自身的局限也很坦诚:样本量为 1、不可复现、难以比较不同模型、日志分析永远不可能完整。我们认为,这种自我设限反而增加了论文的可信度。需要观察的是,CRUX 由 17 位研究者组成,其中多位来自政府、学术界和公民社会,资金来自 Coefficient Giving、Schmidt Sciences 和 Princeton AI Lab,其评估结果是否会带有特定的政策倾向,以及这类评估能否形成可被广泛接受的规范,目前都还是开放问题。对中文读者而言,最实际的价值在于:这套方法论可以直接用来检验国内模型在真实业务场景中的能力上限,而不必依赖厂商自己发布的 benchmark 分数。
背景与影响
当前 AI 社区评估模型能力的主流方式是 benchmark,例如 METR 的时间跨度图被政策分析者、产业领袖和 AI 风险研究机构广泛引用,用以论证 AI 能力正在快速提升。但论文指出,benchmark 存在系统性盲区:为了让任务可被精确指定和自动验证,任务必须足够规整,而足够规整的任务也足够容易被针对性优化,尤其是当评估平台同时充当强化学习训练平台时,模型可能直接在这些 benchmark 的数据上训练。另一方面,benchmark 也可能低估能力,因为真实世界中 CAPTCHA、政策拒绝、基础设施故障等偶发障碍会拉低分数,而这些障碍与所测能力本身无关。近年来已有多项研究尝试在更真实的环境中测试 AI,例如 Nicholas Carlini 用 Claude agent 构建可编译 Linux 内核的 C 编译器,Anthropic 与 Andon Labs 让 Claude 经营办公室小店。论文将这些实践归纳为「开放世界评估」,并提出五条界定标准:开放性、复杂度/长度、任务数量、人工介入、评估方法。CRUX 是团队试图系统化开展此类评估的尝试,未来计划评估 AI 研发自动化、AI 治理、视频生成等方向。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。