Interconnects 作者 Nathan Lambert 出版后训练教材,配套 12 小时课程免费开放
来源Interconnects查看原文
速览
- Nathan Lambert 的后训练教材正式由 Manning 出版,网站版免费
- 内容覆盖 PPO、GRPO、GSPO、CISPO 等 RL 算法及系统设计
- 书中梳理后训练三个历史阶段:2018 年前、2019-2022、2023 至今
- 第 12 章专门解释蒸馏技术,回应外界对蒸馏的争议性描述
- 后半部分讨论过度优化、正则化、评估与角色训练等实操问题
- 作者强调研究落地周期已从数年缩短至 3-9 个月
- 配套 12 小时课程与代码库,降低入门门槛
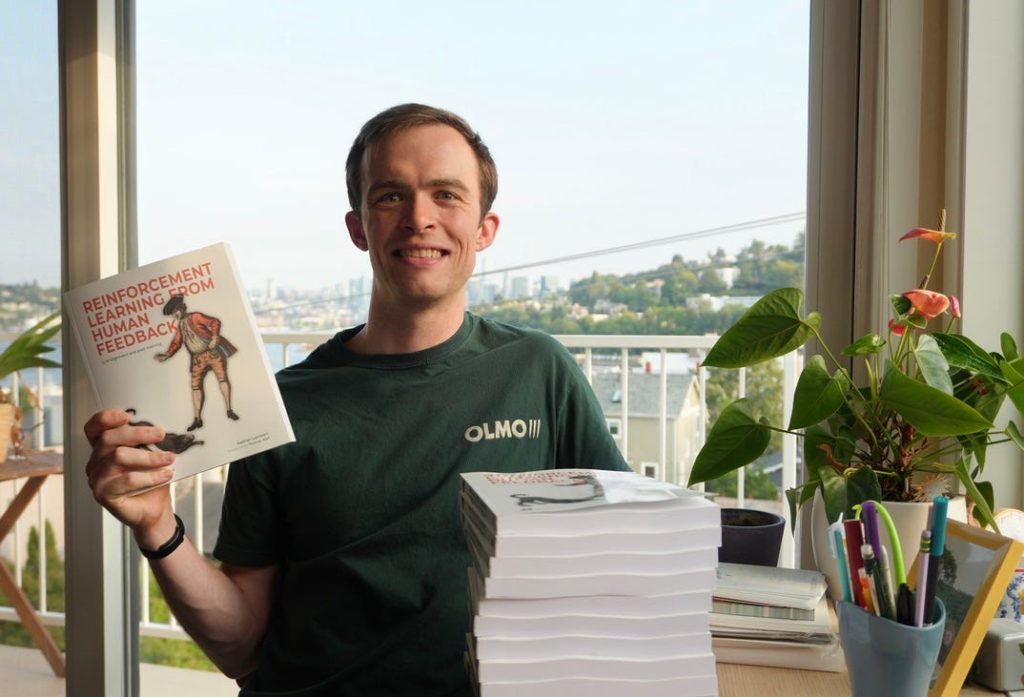
AI 研究者、Interconnects 作者 Nathan Lambert 宣布其后训练教材正式出版,书名为《Reinforcement Learning from Human Feedback: Aligning and Post-training LLMs》,由 Manning 出版。该书源自他此前搭建的 rlhfbook.com 网站,内容覆盖 RL 算法直觉、RL 系统设计、后训练历史、蒸馏技术以及后训练常见陷阱等主题。全书约 25% 篇幅讲强化学习,配套 12 小时课程(幻灯片与 YouTube 视频)、代码库和练习,网站版本免费开放。Manning 平台在 8 月 19 日前使用优惠码 PBLambert 可享 5 折,美国 Amazon 已开售,英国 Amazon 将于 10 月上架。
关键事实
- 书名《Reinforcement Learning from Human Feedback: Aligning and Post-training LLMs》,由 Manning 出版
- 全书约 25% 篇幅用于讲解强化学习算法
- 配套 12 小时课程,含幻灯片与 YouTube 视频,另有代码库和练习
- Manning 平台 8 月 19 日前使用优惠码 PBLambert 可享 5 折
- 美国 Amazon 已开售,英国 Amazon 将于 10 月上架
- 网站 rlhfbook.com 免费开放全部内容
本站视角
对中文开发者尤其是做开源模型后训练、Agent 系统的团队来说,这本书的价值在于它把散落在论文和博客中的后训练方法系统化,并配有可运行的代码和练习。目前中文社区在后训练领域的系统性资料仍然稀缺,多数人靠零散论文和工程经验拼凑,这本书的免费网站版和 12 小时课程降低了获取门槛。我们认为,作者强调的「研究品味」判断值得重视:论文到前沿模型的落地周期缩短到 3-9 个月,意味着依赖特定 LLM 能力做产品的公司如果对研究进展反应迟钝,可能在一个产品周期内就被甩开。需要观察的是,书中对蒸馏的讨论是否真能起到作者所说的「降温」作用——蒸馏在商业和政策层面争议较大,一本教材的技术解释未必能改变各方的立场。另外,本书标题中仍保留 RLHF 这一表述,作者本人也承认标题略显过时,读者在选购时应注意内容实际覆盖范围比标题更广。
背景与影响
Nathan Lambert 是 AI 研究者和 Interconnects 通讯作者,长期参与开源模型训练。他此前搭建 rlhfbook.com 网站,用于记录后训练中缺乏在线资料的关键方法,如拒绝采样、结果奖励模型和角色训练,该网站因此获得一定关注度。本书即在此基础上扩展而成,部分内容改写自 Interconnects 的旧博客文章,因此解释性文字比一般教材更具个人风格。作者表示,书中内容面向已具备计算机科学本科学历的读者,并非纯入门读物。值得注意的是,书中在最后阶段加入了 on-policy distillation 章节,说明内容更新紧跟领域进展。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。