写AI教材的作者:模型长文写作停滞,2-5年内仍难替代人类
来源Interconnects查看原文
速览
- LLM 在非虚构长文写作上进展停滞,与编程、数学的快速进步形成反差。
- GPT 系列擅长找错别字,Claude 系列更适合当编辑,但都无法独立写好整章。
- 模型能处理句子级任务,却难以在多次增补中保持组织连贯,错误会复合累积。
- AI 目前只能节省 10-20% 的写作工作量,短期内不会成为主流。
- 作者预计 2-5 年内最好的教材仍需人类深度打磨。
- 模型在可验证领域和大量上下文下的小编辑上表现好,开放式生成散文则差。
- 长文写作的停滞可能预示模型在开放式科学问题上也有根本局限。
- 用 AI 写非虚构会削弱作者自身理解与品味的成长,非专家更难发现其缺陷。
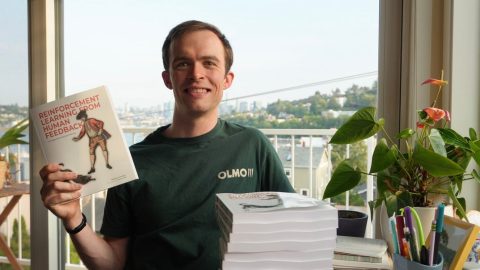
AI 研究者 Nathan Lambert 在完成其 post-training 教材《Reinforcement Learning from Human Feedback》后撰文指出,LLM 在非虚构长文写作上进展明显停滞,与编程、数学等领域的快速进步形成反差。他以自己写书过程为例:GPT 系列擅长找错别字,Claude 系列更适合当编辑,但让模型独立写一整章会出现组织混乱、措辞含糊和概念错误。他认为模型只能节省 10-20% 的写作工作量,且这一比例短期内不会成为主流,预计 2-5 年内最好的教材仍需人类深度打磨。
关键事实
- Nathan Lambert 完成了 post-training 教材《Reinforcement Learning from Human Feedback》,由 Manning 出版,可在 Amazon 购买。
- 他将接近定稿的 200-300 页 PDF 交给 GPT 5.5 Pro,模型找出了多处深层的细微错别字。
- 他认为 Claude 系列作为编辑更有品味、更能理解任务心智模型,能给出更有趣的建议来突破写作瓶颈。
- 书中不到 1% 的技术解释性句子来自 AI 模型,且是在他作为专家认可其表达后才采用。
- 他同时维护 Markdown 和 LaTeX 两个版本的书稿,若无 AI agent 同步,耗时将至少增加五倍(该任务本身已花费数十小时)。
- 他认为 AI 目前只能节省 10-20% 的写作工作量,且这一比例短期内不会变成多数。
本站视角
对中文开发者、AI 写作者和做 Agent 的团队来说,这篇文章提供了一个反直觉的判断:模型在代码和数学上突飞猛进,但在非虚构长文写作上几乎原地踏步。这意味着,如果你的产品依赖模型自动生成技术文档、教材或长篇报告,短期内不要期待质量有质变;相反,把模型定位为「编辑助手」——找错别字、给建议、同步多版本——才是当前更现实的用法。对做 Agent 的团队,作者指出的「复合错误」问题值得警惕:模型能处理单句,却难以在多次增补中保持全局一致,这可能是长任务 Agent 的共性瓶颈。对科研用户,作者认为长文写作的停滞是模型无法自主解决开放式科学问题的先兆,这一判断如果成立,将影响对 AI for Science 时间表的预期。需要指出的是,这是作者基于个人写书经验的主观判断,样本单一,且他本人对 AI 持乐观态度,其「2-5 年」的预测属于个人估计而非实证结论。另外,他提到 Anthropic 同日发布 Claude 在 Riemann Hypothesis 上的进展,与他的悲观判断形成张力,读者应同时关注两方面证据。
背景与影响
Nathan Lambert 是 AI 研究者,运营 Interconnects 博客,长期关注 post-training 与 RLHF。他刚完成一本关于 RLHF 的教材,写作过程中大量使用 LLM 辅助,包括处理 LaTeX 公式格式、大量文字编辑、生成 TikZ 和 Python 图表等。他原本担心 2026 年出版非虚构书会因 AI 进步而显得过时,但实际结果是模型在非虚构写作上远未达到预期,这让他对书的持久价值更有信心。他提到当前写作能力最强的模型包括 OpenAI 的 GPT 4.5 和 Moonshot 的 Kimi K2,这些模型发布已有一段时间。他认为写作能力与模型擅长的其他技能正交,且缺乏专门干预的训练数据。他还引用 Jasmine Sun 关于 LLM 是好评委但差写手的文章作为佐证。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。