Z.ai 发布 GLM-5.3:仅靠后训练追平前沿
来源Interconnects查看原文
速览
- GLM-5.3 与 GLM-5.2 同基座,提升全部来自后训练扩展。
- 约 750B 参数即达到 agentic coding 前沿水平,约为 Kimi K3 的三分之一。
- 部分基准超过 Claude Fable 5 与 GPT-5.6-Sol,也超过 Kimi K3。
- 作者认为蒸馏不是中国实验室贴近前沿的主因。
- 美国实验室发布周期以月计,中国实验室以天计,这是最大变量。
- Z.ai 对公开基准的重视程度高于 OpenAI 与 Anthropic。
- GLM-5.3 定位比 Claude Fable、GPT Sol 更窄,且为纯文本模型。
- 中国 RL 数据产业正在兴起,部分由美国数据公司向中国模型实验室供货驱动。
- Z.ai 与清华关系紧密,算力效率可能高于 OpenAI 与 Anthropic。
- GLM-5.3 网络安全能力双用途,Z.ai 采取分阶段发布。
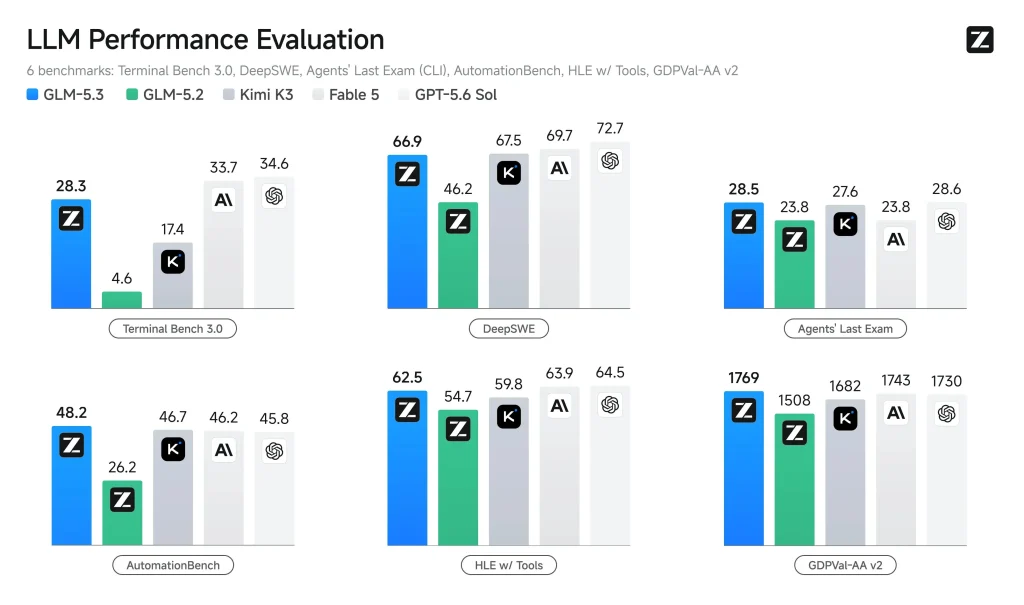
Z.ai 发布 GLM-5.3,目前仅在 coding plan 中提供,即将上线 API,两周后在 Hugging Face 开放权重。该模型与 GLM-5.2 使用同一基座模型,主要变化来自大幅扩展的后训练。Z.ai 官方博客称「我们为 GLM-5.3 所做的全部就是扩展后训练」。模型参数量约 750B,约为 Kimi K3 的三分之一,但在多个 agentic coding 基准上已超过 Moonshot AI 的 Kimi K3,部分基准上超过 Claude Fable 5 或 GPT-5.6-Sol。作者认为,中国实验室能持续贴近前沿,主因不是蒸馏,而是更快的发布节奏、对公开基准的更高重视、更窄的模型定位、中国 RL 数据产业的兴起,以及 Z.ai 本身极高的算力效率。
关键事实
- Z.ai 于今日发布 GLM-5.3,目前仅在 coding plan 中可用,即将上线 API,两周后在 Hugging Face 开放权重。
- GLM-5.3 与 GLM-5.2 使用同一基座模型,Z.ai 称「为 GLM-5.3 所做的全部就是扩展后训练」。
- 模型参数量约 750B,约为 Kimi K3 的三分之一。
- 在多个基准上超过 Moonshot AI 的 Kimi K3,部分基准上超过 Claude Fable 5 或 GPT-5.6-Sol。
- Z.ai 称使用了更多环境、更多样化的任务,以及更多用于训练这些环境的算力。
- Z.ai 报告称其年化经常性收入(ARR)达到 10 亿美元,主要来自本地化部署业务。
本站视角
对中文开发者来说,GLM-5.3 的实际意义不在于榜单排名,而在于两周后开放权重。约 750B 参数、纯文本、主打 agentic coding,意味着它可以在单机多卡或中小规模集群上自部署,这对做代码 Agent、内部研发工具链、以及需要数据不出内网的团队是直接可选项。相比之下,Claude Fable 5 或 GPT-5.6-Sol 只能通过 API 使用,成本和合规约束都更高。 我们认为,这篇文章最有价值的部分不是对 GLM-5.3 的赞美,而是作者对「中国实验室为何追得上」的结构性解释。其中「发布节奏」这一条尤其值得国内团队重视:如果美国实验室确实把数月时间花在发布前测试上,而中国实验室把同样时间用于继续爬坡,那么榜单上的差距会被系统性压缩。但这也意味着,榜单领先并不等于真实场景领先——GLM-5.3 是更窄的模型,纯文本、无视觉能力,在通用对话、多模态、长尾企业用例上大概率仍与 Claude、GPT 有距离。把它当成「代码 Agent 的高性价比基座」是合理的,把它当成「全面追平前沿」则是过度解读。 需要观察的是作者提到的中国 RL 数据产业。如果中国实验室确实能买到与美国前沿实验室相同的 RL 环境,那么「蒸馏」这个流行解释就站不住脚,真正的变量是数据供应链的全球化。这一点目前只有单一来源和传闻支撑,作者自己也说「误差棒很大」,不宜当作定论。 另一个值得国内团队注意的是安全叙事。Z.ai 主动承认网络安全能力的双用途风险并采取分阶段发布,这在开源模型厂商中并不常见。但作者点出的问题同样成立:一旦权重公开,任何平台侧的分类器和思维链监控都无法约束下游修改。对使用 GLM-5.3 做安全相关产品的团队来说,这意味着能力可得性与责任边界需要自己重新划定,不能指望模型方的安全措施兜底。 最后,作者对 OpenAI 与 Anthropic「跑去找政府要政策帮助」而不是修补推理轨迹提取的批评,带有明显的立场。这一判断是否成立,取决于那些提取方法在真实训练管线中的实际收益,目前公开证据有限,读者应把它当作观点而非事实。
背景与影响
GLM 系列并非突然出现。智谱 AI 成立于 2019 年,GLM(General Language Model)论文于 2021 年 3 月由清华大学 THUDM 发布,此后经历 GLM-130B(2022 年 8 月)、ChatGLM(2023 年 3 月 14 日)、ChatGLM2(2023 年 6 月 25 日)、ChatGLM3(2023 年 10 月 27 日)、GLM-4(2024 年 1 月 16 日)、GLM-5(2026 年 2 月 11 日)到 GLM-5.2(2026 年 6 月 22 日)。作者称 GLM-5.2 发布数周后,仍有认识的 AI 研究者因其速度快、部署简单而继续使用,说明该系列在开发者中已有实际口碑。 关于「中国实验室为何能持续贴近前沿」,作者列出六点解释。第一,发布节奏:Z.ai 从模型完成到公开发布可能只需数天,而 OpenAI 与 Anthropic 往往需要数月,这意味着美国实验室在发布前测试期,中国实验室仍在基准上继续爬坡。作者认为这可能是最大的单一因素。第二,Z.ai 对公开基准的重视程度更高,因为 Artificial Analysis Intelligence Index 这类聚合榜单直接影响其股价与融资能力。第三,Z.ai 并未把 GLM-5.3 训到「烤糊」的程度,作者认为其发布博客中的基准分数是真实的。第四,GLM-5.3 的定位比 Claude Fable 或 GPT Sol 更窄,且旗舰 GLM 模型一直没有视觉能力,纯文本定位有助于拿到更有竞争力的分数。第五,中国的 RL 数据产业正在起飞,部分由美国数据公司向中国模型实验室销售数据驱动,中国实验室可能买到与美国前沿实验室相同的 RL 环境,并更早发布下游模型。第六,Z.ai 本身是极其熟练的 LLM 组织,与清华关系紧密,算力效率可能高于 OpenAI 与 Anthropic。 作者还提到,近期有一篇论文展示了从前沿模型提取推理轨迹的简单方法,这类手段中国实验室完全可以规模化使用;他不理解美国实验室为何没有更快修补这一行为,反而转向政府寻求政策帮助。 在安全方面,Z.ai 承认 GLM-5.3 在漏洞发现、漏洞利用分析和复杂多步安全任务上有大幅提升,同时存在明显的双用途风险,因此采取分阶段发布,并通过请求分类器和思维链监控来监测平台上的推理。作者认为,在真正的开放权重即将到来之际,这类安全措施作用有限——如果不是 GLM-5.3,也会有别的模型;具备这些能力的模型体积正在缩小,更容易被修改和部署,甚至可能绕过安全措施。作者呼吁由政府或行业联盟主导的工业级指导,为整个软件行业迎接这一转变做好准备。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。
