NVIDIA Nemotron 支持 UK-LLM 项目覆盖凯尔特语言
来源NVIDIA Deep Learning查看原文
速览
- UK-LLM 借助 NVIDIA Nemotron 服务英国凯尔特语言使用者
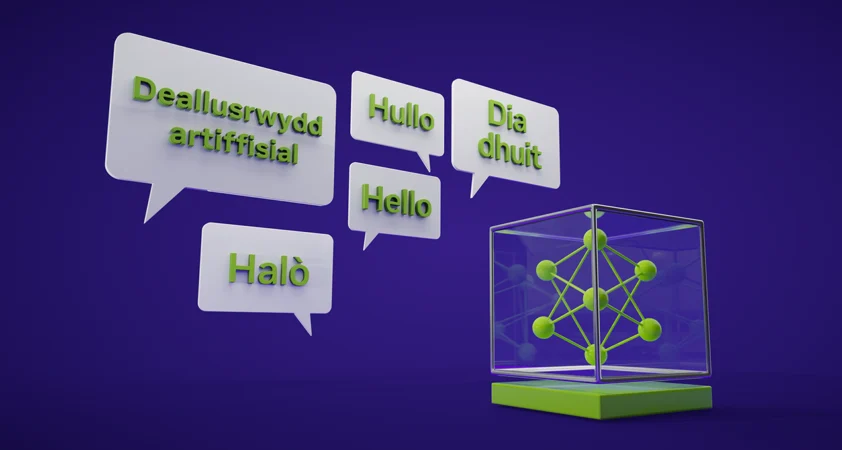
- 涉及康沃尔语、爱尔兰语、苏格兰盖尔语、威尔士语四种语言
- NVIDIA 以官方博客形式披露该合作
- 原文未给出模型参数、数据规模与评测结果
NVIDIA 深度学习博客披露,UK-LLM 项目正借助 NVIDIA Nemotron 为英国最古老的现存语言提供 AI 支持,涉及的语言包括康沃尔语、爱尔兰语、苏格兰盖尔语和威尔士语。原文仅给出项目目标与语言范围,未披露模型规模、训练数据量、发布时间或性能指标。
关键事实
- UK-LLM 项目使用 NVIDIA Nemotron 为英国语言提供 AI 能力
- 覆盖语言包括康沃尔语、爱尔兰语、苏格兰盖尔语和威尔士语
- 这些语言被描述为英国最古老的现存语言
- 消息来源为 NVIDIA Deep Learning 官方博客
本站视角
这件事的直接受益者不是通用 AI 开发者,而是三类具体人群:一是英国凯尔特语言社区的使用者与语言保护机构,他们可能首次获得可用的本地语言 AI 工具;二是做低资源语言 NLP 的研究团队,UK-LLM 与 Nemotron 的组合提供了一个可参考的技术路径;三是国内做少数民族语言或方言数字化的团队,这类项目的方法论——用可定制基座模型加社区语料做适配——对藏语、维吾尔语、粤语、闽南语等场景有直接借鉴意义。我们的判断是:这更像一次生态卡位而非技术突破。英伟达在开源模型上的投入,核心目的是扩大 Nemotron 的使用面,让更多机构把微调与推理跑在自家生态里;语言保护本身是正当需求,但厂商叙事容易把「支持某语言」说得比实际能力更强。可疑之处在于,原文只有 NVIDIA 单方面披露,没有 UK-LLM 方的独立说明,也没有任何量化指标——没有词表覆盖率、没有翻译或生成质量的 benchmark、没有用户规模。对读者来说,值得跟进但不必高估:真正该看的是后续是否放出模型权重、评测集和社区反馈,而不是新闻稿里的语言清单。
背景与影响
凯尔特语言是英国境内历史最悠久的现存语言,但长期处于英语主导环境之下,数字工具与语言模型的支持相对薄弱。低资源语言在通用大模型中的表现通常明显落后于英语等高资源语言,原因在于训练语料稀缺、标注成本高、社区规模小。UK-LLM 这类项目通常的做法是联合本地高校与语言社区,用开源或可定制的基座模型做继续预训练与指令微调,再配套评测集。NVIDIA 的 Nemotron 系列是其开放模型与数据管线品牌,此次被 UK-LLM 采用,意味着英伟达在英语之外的区域性语言场景中寻找落地案例。需要观察的是,原文没有说明 Nemotron 在项目中承担的是基座模型、微调框架还是算力支持,也没有给出任何语言能力评测数据,因此目前只能确认合作方向,无法判断实际效果。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。