AI 实验室向上迁移:逃离商品化陷阱与锁定风险
来源AI Snake Oil查看原文
速览
- 模型推理符合 Bertrand 悖论条件,长期价格趋向边际成本,模型层难有持久利润。
- 历史显示基础设施提供者很少能捕获自己创造的价值,铁路、电信、航空均是如此。
- 企业软件靠零边际成本、切换成本和非短暂价值维持 75% 以上毛利率。
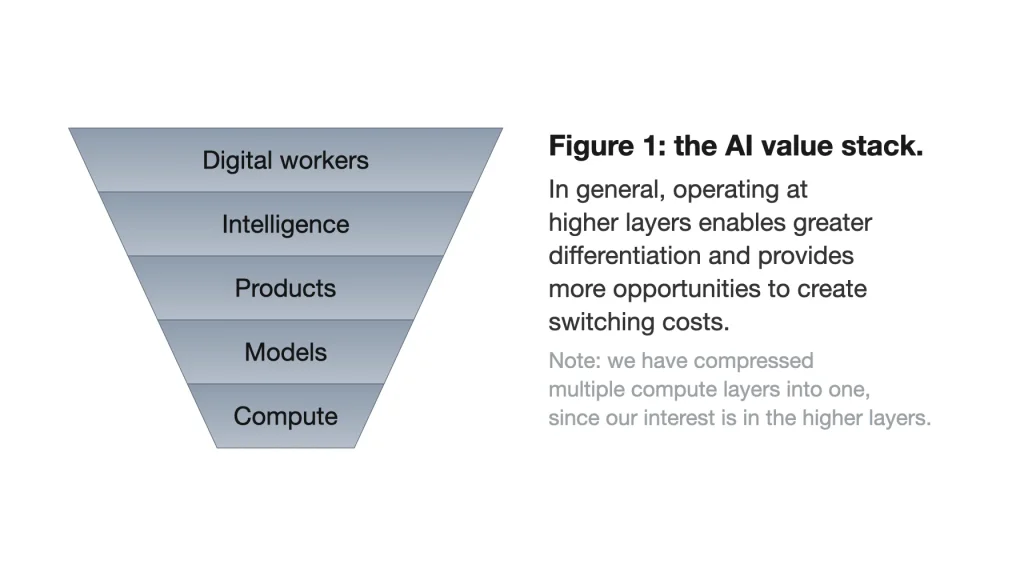
- AI 实验室正通过产品、AI 原生 SaaS、定制部署和数字员工向上迁移。
- 护城河分嵌入型、生态型、商业型、行为型四类,另有按结果定价策略。
- 数字员工若无法「解雇」,锁定程度可能超过最糟糕的企业软件。
- 若实验室成功锁定客户,将抬高企业成本并固化少数玩家的结构性优势。
- 反垄断机构目前只关注栈底,作者认为必须扩大分析范围。
普林斯顿学者 Arvind Narayanan 和 Akash Kapur 在 AI Snake Oil 发表长文,跳出「AI 是不是泡沫」的争论,从历史与经济学理论出发分析 AI 实验室的长期盈利路径。文章认为,模型推理业务因模型同质化、资本成本相近、切换成本极低、价格可自由调整,符合 Bertrand 悖论的条件,长期看价格会被压到边际成本,模型层难以维持高利润。作者梳理铁路、电力、电信光纤、云计算、半导体制造、商业航空六个资本密集型基础设施行业的历史,指出基础设施提供者往往无法捕获自己创造的价值,而企业软件凭借零边际复制成本、深度切换成本和非短暂价值维持 75% 以上的毛利率。因此,AI 实验室最可能的出路是「向上迁移」——通过垂直整合、嵌入式企业部署、构建切换成本和护城河来捕获价值。文章列举了嵌入型、生态型、商业型、行为型四类护城河以及按结果定价的策略,并指出这一趋势会带来客户锁定和竞争减少的新问题,反垄断机构目前只关注栈底,需要扩大视野。
关键事实
- 麦肯锡预计到 2030 年代初 AI 基础设施投资规模为 4 万亿至 8 万亿美元,文章以此作为需要回收的投资基数。
- 作者假设 5% 的净利率(高于航空业)和 5 年回收期,推算出需要每年 16 万亿至 32 万亿美元的收入,高端约为当今世界 GDP 的四分之一。
- 1990 年代末电信和光纤建设中,容量在七年内增长 186,000 倍,价格崩溃,约 2 万亿美元市值蒸发。
- 商业航空 80 年来持续摧毁投资者资本,典型净利率仅 2%–4%,常低于资本成本。
- 企业软件数十年来维持 75% 或以上的毛利率,依靠零边际复制成本、深度切换成本和可摊销数十年的非短暂价值三个属性。
- 两个例外是云计算和芯片代工:云计算获得类软件属性(托管服务锁定、出口费、承诺支出协议),TSMC 在先进制程上接近垄断。
本站视角
这篇文章对中文读者最直接的价值,是提供了一个比「泡沫论」更可操作的判断框架:不要只盯着实验室的季度亏损或收入增速,而要问「价值最终在栈的哪一层被捕获」。对国内做 Agent 和应用层的团队来说,作者的判断意味着一个不太舒服的前景——如果 OpenAI、Anthropic 这类实验室真的把护城河建在嵌入型状态、编排层和数字员工上,那么今天依赖模型 API 做薄封装的产品,未来可能同时面对模型层降价和上层锁定的双重挤压。国内大模型厂商同样值得对照:模型同质化、价格战、切换成本低这些条件在中国市场只会更极端,向上迁移几乎是唯一出路,但国内缺少成熟的企业软件付费土壤,按结果定价的测量难题会更难解决。我们认同作者对「过渡期不等于均衡」的强调,这是当前讨论中最常被忽略的一点。但需要指出,文章的核心论证建立在历史类比和经济理论推演之上,而非实证数据,作者自己也承认「硬起飞」情景无法证伪;4 万亿至 8 万亿美元的投资基数和 16 万亿至 32 万亿美元的收入推算来自麦肯锡的预测和作者的假设,属于情景推演而非事实。此外,文章对护城河能否真正建立多次使用「开放问题」「可疑」等措辞,说明作者本人对结论也保留余地。对中文读者而言,最需要观察的是:开源标准和 MCP 这类协议能否让编排层保持「薄且可替换」,这直接决定价值是流向实验室还是流向企业和集成商。
背景与影响
这篇文章来自 AI Snake Oil(normaltech.ai),作者 Arvind Narayanan 是普林斯顿计算机科学教授,Akash Kapur 是普林斯顿访问学者、New America 高级研究员。文章延续了「AI as Normal Technology」框架,主张把 AI 当作普通技术,从历史中寻找可类比的经验。当前关于 AI 的讨论分裂为两派:批评者指出实验室巨额亏损、资本支出与收入之间的缺口;支持者则援引收入快速增长、企业采用以及 Anthropic 首个盈利季度等里程碑。作者认为两派都犯了同一个错误——把过渡期当成均衡状态。文章还提到 AI 发展过程中的几次波动:一度超前于需求的基础设施建设、DeepSeek 时刻(开源权重模型几乎追平前沿)、企业采用 AI agent 带来的 token 稀缺,以及最近企业重新考虑前沿模型支出、推动竞争性开源生态。作者引用了多位同行的观点:Mihir Kshirsagar 认为监管而非经济规律才是历史上基础设施企业无法提取剩余价值的主因;Benedikt Evans、Luis Garicano 和 Jesús Saa-Requejo 认为价值会在硬件层和实施层被捕获,但假设实验室只能做模型供应商;Semianalysis 认为算力稀缺能让实验室维持高毛利;Nathan Lambert 预测会出现双层 AI 经济,前沿实验室会放任 API 业务衰退以保护高毛利产品。作者表示自己的新意在于:证明模型推理比历史先例更符合毁灭性竞争的前提条件,同时指出 AI 栈很厚、商品化陷阱只适用于模型层,且实验室已清楚认识到问题并正在积极迁移。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。