普林斯顿新论文:AI Agent 可靠性提升远慢于能力提升
来源AI Snake Oil查看原文
速览
- AI Agent 可靠性缺乏统一定义与测量工具,论文提出四维度 12 指标框架。
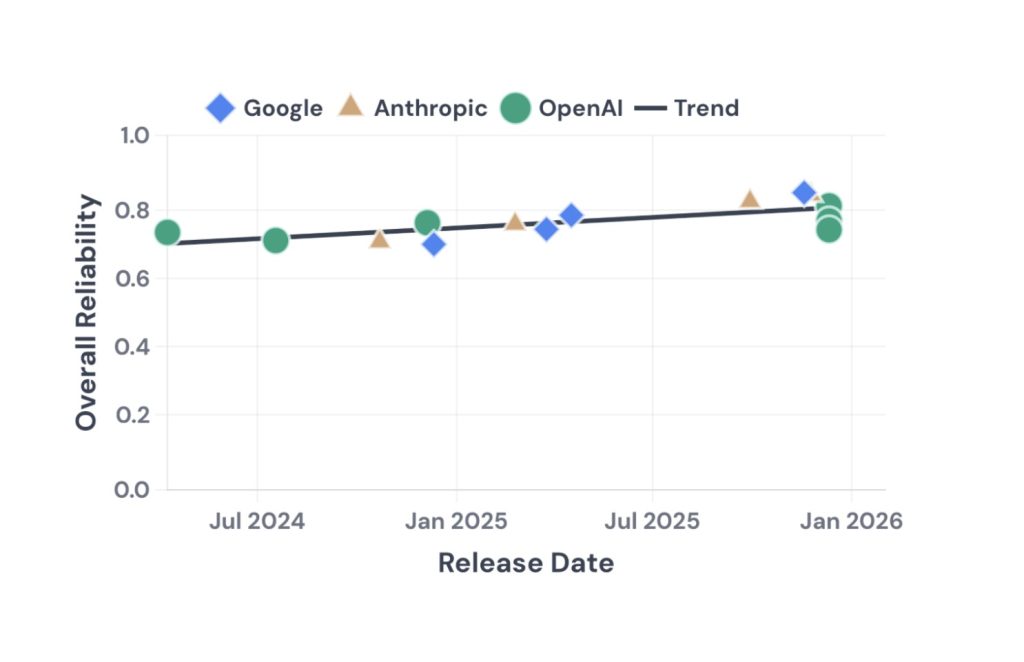
- 18 个月内模型能力大幅提升,可靠性仅温和改善,三家主要厂商表现接近。
- 一致性得分仅 30%–75%,同一任务重复运行结果不稳定。
- 校准性最弱,模型往往无法判断自己何时会出错。
- 指令改写后性能明显下降,说明鲁棒性不足。
- 近期模型在避免约束违规上改善,但财务类错误仍常见。
- 模型变大不等于更可靠,部分维度反而变差。
- 论文建议部署方区分自动化与增强场景,并设定可靠性门槛。
- 团队计划推出 AI Agent 可靠性指数,推动社区系统追踪。
普林斯顿大学的研究团队(包括 AI Snake Oil 作者 Arvind Narayanan、Sayash Kapoor 及博士后 Stephan Rabanser 等人)发布论文《Towards a Science of AI Agent Reliability》,提出将 AI Agent 的可靠性拆解为一致性、鲁棒性、校准性、安全性四个维度、共 12 项指标,并基于 GAIA 和 TauBench 两个基准测试了 OpenAI、Google、Anthropic 的 14 个模型,共执行 500 次基准运行。结果显示,过去约 18 个月中模型能力快速提升,但可靠性仅温和改善,且三家主要厂商表现接近,说明这是行业普遍问题。团队计划推出 AI Agent「可靠性指数」,并呼吁业界在报告准确率之外同时报告可靠性画像。
关键事实
- 论文将可靠性分解为一致性、鲁棒性、校准性、安全性四个维度,并细化为 12 项指标。
- 测试覆盖 OpenAI、Google、Anthropic 的 14 个模型,时间跨度 18 个月,使用 GAIA 和 TauBench 两个基准,共执行 500 次基准运行。
- 每个任务运行 5 次并改写指令措辞,同时在工具和环境中注入故障以测量鲁棒性。
- 一致性方面,各模型的结果一致性得分在 30% 到 75% 之间。
- 校准性(模型对自身正确性的判断)是四个维度中最弱的,在某基准上多数模型区分正确与错误预测的能力不优于随机。
- 鲁棒性方面,多数模型能应对服务器崩溃、API 超时等技术故障,但指令改写后性能显著下降。
本站视角
这篇论文的价值不在于提出某个新模型或新能力,而在于给「AI Agent 到底能不能用」这个问题提供了一个可操作的测量框架。对国内做 Agent 产品的团队来说,最直接的冲击是:过去两年大家比拼的是任务成功率,但论文数据显示,同一任务重复运行的结果一致性只有 30%–75%,指令换个说法性能就明显下降,模型还普遍不知道自己什么时候会错。这意味着很多在 demo 里跑通的产品,一旦进入真实生产环境、面对措辞各异的用户输入和偶发的 API 故障,失败率会远高于基准分数所暗示的水平。对用 API 构建客服、自动化工作流的中小企业,论文的建议很具体:区分「增强人」和「替代人」两类场景,前者可以容忍低可靠性,后者必须设定可靠性门槛再上线。我们认为,论文最值得重视的判断是「能力提升不会自动带来可靠性提升」——三家主要厂商在可靠性上表现接近,说明这不是某家公司的工程问题,而是当前 LLM Agent 范式的结构性短板。需要指出的是,论文自己也承认发现是初步的(tentative),维度划分带有主观性,安全性指标仍在迭代、未计入综合可靠性得分,且部分结论基于线性外推的讨论。因此不宜把具体数字当作定论,但「可靠性应作为独立维度被测量和优化」这一主张,对国内 Agent 团队有实际参考价值。另一个需要观察的点是,论文提出的可靠性指数能否被业界采纳为通用标准,还是像许多学术基准一样停留在论文里。
背景与影响
AI Agent 的可靠性问题早已被广泛讨论,此前已有多起 Agent 出错事件被媒体报道,例如 Replit 的 AI 编程工具删除公司数据库、OpenAI 的 Operator 出现异常行为、纽约市 AI 聊天机器人建议企业违法等。但业界一直缺乏对可靠性的统一定义和测量工具,评估通常只依赖任务平均成功率这一个数字。该论文借鉴航空、核能、汽车等安全关键工程领域的经验——这些领域数十年前就认识到可靠性不等于平均性能,并独立收敛到一致性、鲁棒性、可预测性、安全性四个维度,例如核反应堆保护系统必须在每次触发时做出相同响应,航空业的目标是每十亿飞行小时不超过一次灾难性错误。论文作者此前已发表《AI Agents that Matter》,指出 Agent 基准测试与实际需求之间存在巨大鸿沟,新论文表明这一鸿沟依然存在。团队还计划推出 AI Agent 可靠性指数,并已将代码开源在 GitHub,同时提供交互式仪表盘。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。