微软推出 Community Library Creator,让社群自建 AI 图像数据
来源Microsoft AI查看原文
速览
- 微软推出 Community Library Creator,让社群自建 AI 图像数据集。
- 每个图书馆约收集 400 张真实图像,附详细描述,用于训练与评估。
- 社群保留数据所有权,可决定共享范围并支持删除个人数据。
- 工具旨在纠正 AI 对残障等群体的刻板或错误呈现。
- 目前仅与特定倡导组织合作,处于受控使用阶段。
- 社群成员通过评分 AI 生成图像,形成反馈循环。
- Thieme 称此举将人和数据权利置于首位,AI 领域需要更多此类做法。
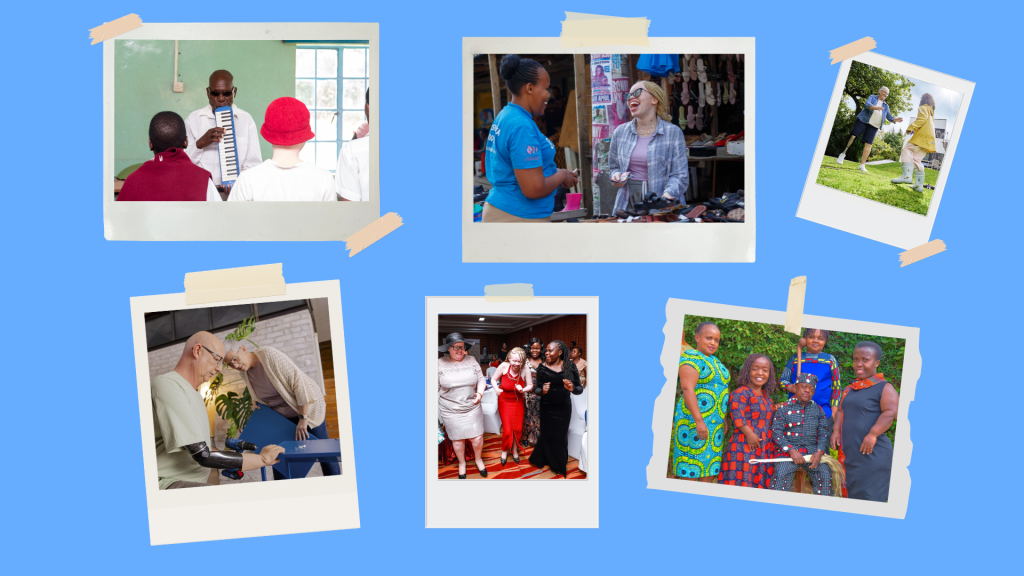
微软研究院发布了一款名为 Community Library Creator 的工具,旨在让特定社群——如残障人士、少数族裔等——通过倡导组织自行创建图像与视频数据集,定义他们希望在 AI 生成图像中被如何呈现。每个社群图书馆计划收集约 400 张来自社群成员的真实世界图像,并附上详细描述,用于训练和评估 AI 系统。社群保留数据所有权,可决定是否将数据共享至 Hugging Face 等平台,并有权要求删除个人数据。该工具目前处于受控使用阶段,仅与特定倡导组织合作。
关键事实
- 微软发布 Community Library Creator,由首席研究员 Anja Thieme 及其团队与微软无障碍团队合作开发。
- 每个社群图书馆计划收集约 400 张来自社群成员的真实世界图像,强调质量而非数量。
- 社群通过倡导组织拥有数据所有权,可决定是否将数据共享至 Hugging Face 等平台,并保留删除个人数据的权利。
- 该工具目前处于受控使用阶段,仅与特定倡导组织合作,Thieme 和 Cecily Morrison 共同领导团队推进扩展所需的安全与法律控制。
- Thieme 指出,网上大量关于侏儒症患者的神秘矮人图像,可能导致 AI 生成带有尖耳朵等奇幻特征的形象。
- 肢体差异者在网上主要被描绘在医疗或运动场景中,导致 AI 缺乏将其置于工作或日常社交场景的上下文。
本站视角
这项工具直接影响到中文开发者、国内做多模态生成和 Agent 的团队,以及使用 API 的中小企业。如果社群图书馆模式被验证有效,它可能成为 AI 训练数据合规与多样性的新范式——不再依赖从互联网无差别抓取,而是由数据主体主动提供并保留控制权。我们认为,这是对当前“先抓取后治理”主流路径的实质性挑战,尤其在欧洲 AI 法案、中国生成式 AI 管理办法等监管趋严的背景下,数据来源的可追溯与同意机制将越来越关键。但需要观察的是:约 400 张图像的规模对于训练大模型而言仍然很小,其实际效果可能更多体现在评估和微调环节,而非从头训练。此外,微软尚未公布任何量化指标证明该方法能显著减少偏见,目前仅有定性描述和个别案例,结论下得较强。社群保留删除权在技术上如何实现、是否会影响已训练模型,原文也未说明。对国内团队而言,这套流程的借鉴意义在于:与其被动等待监管,不如主动与垂直社群合作,建立小规模但高质量、可审计的数据集,这可能是未来差异化竞争的一个切入点。
背景与影响
AI 模型通常从互联网大规模抓取图像和文本进行训练,这些数据往往未经被呈现者的同意,且包含大量偏见与刻板印象。例如,网上关于侏儒症患者的图像常与奇幻矮人形象关联,导致 AI 生成错误特征;肢体差异者则多被置于医疗或运动场景,缺乏日常生活的呈现。微软研究院的 Community Library Creator 试图改变这一现状,让受影响的社群通过倡导组织主动定义自己的呈现方式,并构建可供 AI 学习的数据集。这延续了微软在负责任 AI 和无障碍设计方面的一贯投入,也呼应了业界对数据同意、所有权和代表性的日益关注。该工具目前仅与少数倡导组织合作,未来可能扩展至更多社群,并用于训练和评估未来的 AI 模型。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。