OpenAI 宣称解决 Navier-Stokes 问题,数学界争议升温
来源IEEE Spectrum AI查看原文
速览
- AI 公司正把千禧年难题当作能力验证与公关展示的战场。
- OpenAI 宣称解决 Navier-Stokes,被视为自动推理的潜在分水岭。
- Anthropic 用未发布 Claude 试攻 Riemann 假设,仅取得相关进展。
- Scholze 批评这类解题更像 benchmark 和 PR stunt,而非数学理解。
- Williamson 指 OpenAI 行为极差,Harris 称其扰乱学科规范。
- AI 能给出答案却常不产出可理解的新方法,评价体系面临重构。
- 青年研究者担心被 LLM 抢先发表,或被迫跟进使用模型。
- 博士生为使用模型自费数千欧元买 token,经济压力显现。
- OpenAI 向学术界发放 10 万份免费许可证,被部分人视为裹挟。
- Robertson 因此把博士方向转向量子安全的社会影响,避免只做 LLM 输出验证。
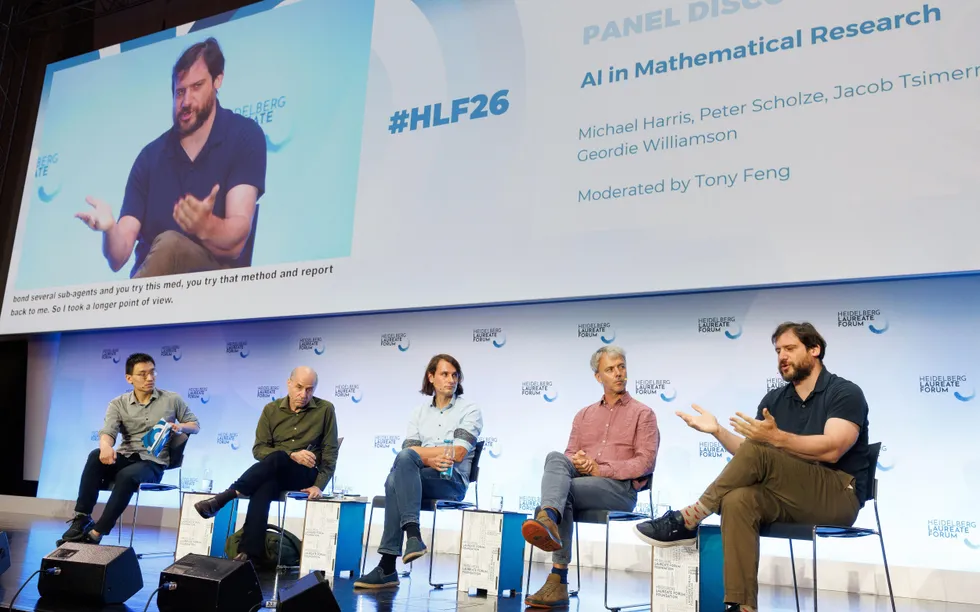
在德国举行的 Heidelberg Laureate Forum 上,AI 公司大举进军数学成为数学家们讨论的焦点。OpenAI 此前宣布解决了千禧年难题之一的 Navier-Stokes 存在性与光滑性问题,Anthropic 则用未公开版本的 Claude 尝试 Riemann 假设并在一相关问题上取得进展,OpenAI 还被报道正瞄准 Hodge 猜想。多位菲尔兹奖得主在论坛上表达不满:Peter Scholze 认为这些公司只是把难题当作 benchmark 和公关噱头;Geordie Williamson 直言 OpenAI 行为极差,并担忧 AI 给出的答案与数学界真正追求的「理解」正在脱钩。与此同时,普通数学研究者正承受压力,有人担心被 LLM 抢先发表成果,有博士生为使用模型耗尽订阅额度甚至自掏数千欧元购买 token。
关键事实
- 9 月 13 日,Heidelberg Laureate Forum 在德国举行,AI 与数学的关系成为与会者讨论的核心话题。
- OpenAI 宣布解决了千禧年难题之一的 Navier-Stokes 存在性与光滑性问题,该问题由 Clay Mathematics Institute 于 2000 年提出,七个难题中此前只有 Poincaré 猜想被人类解决。
- 菲尔兹奖得主 Jacob Tsimerman 表示 AI 能力增长快于包括他在内许多人的预期,并称解决 Navier-Stokes「感觉相当确凿」。
- Anthropic 在 8 月用未发布的 Claude 版本尝试 Riemann 假设,在一个相关问题上有重要进展,但未攻克主目标。
- OpenAI 被报道正聚焦于解决 Hodge 猜想。
- 菲尔兹奖得主 Peter Scholze 在论坛小组讨论中称,这些公司解决难题只是把它们当作 benchmark 和某种公关噱头。
本站视角
这件事最直接的冲击对象是两类人。第一类是高校与科研机构里的数学研究者,尤其是博士生和青年学者:他们的职业评价体系建立在「解决难题」和「优先发表」之上,而 LLM 让解题速度与成果归属变得模糊。Robertson 的同事为 token 花掉数千欧元、Ramabulana 的课题被 OpenAI 的进展覆盖,都是这种压力的具体表现。第二类是依赖数学与形式化推理的产业团队,包括做自动定理证明、形式化验证、量子安全密码的团队——如果前沿模型真能稳定产出可验证的新证明,这些领域的工作方式会被重写。 我们的判断是:OpenAI 宣称解决 Navier-Stokes 目前仍是一个需要独立验证的声明,而非已被数学界接受的结论。Tsimerman 说「感觉相当确凿」,但他也承认不了解细节;Scholze 则直接把它定性为 benchmark 和公关噱头。这两种态度之间的落差,恰恰说明该声明在证据层面尚未闭合。需要观察的是:证明是否经过同行评议、是否公开可复现、是否带来可被人类理解的新方法。如果只是给出答案而没有方法论,那它对数学的贡献与对 OpenAI 品牌的价值并不对等。 同样值得注意的是报道中的伦理争议。Harris 转述 Tristan Buckmaster 的说法,称 OpenAI 的沟通带有胁迫、审查甚至威胁意味,而 OpenAI 未回应置评请求。这里的事实来源是单一转述,读者应保持审慎;但 Williamson 在公开小组讨论上的批评、以及多位数学家对「霸凌和扰乱学科规范」的共识,说明这已不是个别抱怨,而是社区层面的情绪。 对中文读者而言,还有一层容易被忽略的影响:如果前沿模型把千禧年难题当作营销素材,那么「AI 能做数学」的叙事会迅速外溢到教育、招聘和科研经费分配中。国内高校和研究院所在制定 AI 使用规范、成果署名规则、算力采购预算时,很可能直接照搬这波讨论的结论。我们建议不要把「AI 解出某难题」当作既成事实来引用,而应区分三件事:模型给出的答案、经过验证的证明、以及数学界认可的理解。这三者之间的差距,才是接下来一两年真正值得跟踪的变量。
背景与影响
千禧年难题由 Clay Mathematics Institute 于 2000 年提出,共七个,每个悬赏 100 万美元,至今只有 Poincaré 猜想被人类解决。数学之所以成为 AI 的理想试验场,在于它要求逐步的逻辑推理,且答案可以被自动、客观地验证。过去一年,AI 从难以应对日常研究级问题,到解决一批 Paul Erdős 提出的趣题,再到验证 Fermat 大定理的证明,进展速度超出许多数学家的预期。OpenAI 关于 Navier-Stokes 的声明如果被验证,将意味着自动推理进入新阶段。与此同时,Anthropic 与 OpenAI 分别把目光投向 Riemann 假设和 Hodge 猜想,且都动用未公开发布的最强模型。这意味着科技巨头正以千禧年难题作为衡量前沿模型能力的标尺,同时向潜在用户与投资者展示技术实力。争议的核心不只是谁先解出难题,而是解题方式是否遵守数学界长期形成的规范:署名、优先权、同行评议、以及对「理解」而非「答案」的追求。Williamson 指出,数学界衡量的是理解,但用未解问题来度量,这两者正快速脱钩,随之而来的是如何评价研究者、谁获得教职、如何培养学生等一系列问题。对普通数学家而言,压力是具体的:担心成果被 LLM 抢先、被迫加大模型使用强度、以及为算力自掏腰包。
本文由 AI 辅助整理自公开信源,事实部分以原文为准;「本站视角」一节为编辑部判断,欢迎指正。版权归原作者所有,如有异议请联系我们。