Tavus 发布 Griffin 模型,48% 测试者误认 AI 为真人
速览
- Tavus 发布 Griffin,称其为全球首个「人类交互模型」。
- 测试中 48% 参与者误认 AI 为真人,上一代仅 2.4%。
- Griffin 用全双工端到端架构取代级联流程,延迟降至 0.43 秒。
- 模型能判断沉默含义,区分对方是说完还是在思考。
- 视频侧通过蒸馏与 Self-Forcing 实现 720p 实时生成。
- VideoFDB 基准上 Griffin-Lite 生成与感知均排第一。
- 测试样本仅 54 人、时长一分钟,未经独立验证。
- Griffin-Lite 尚未对客户开放,仅限少数受信任测试者。
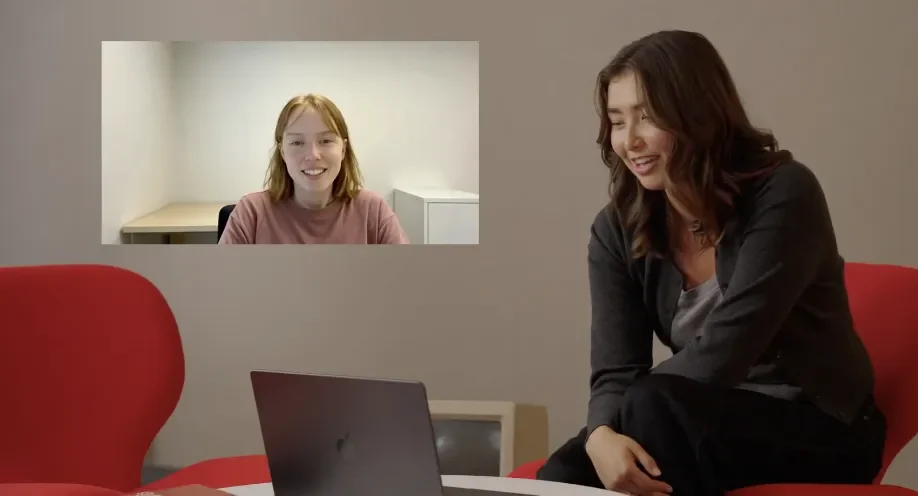
10 月 1 日,美国 AI 视频公司 Tavus 发布名为 Griffin 的模型,定义为全球首个「人类交互模型」(Human Interaction Model,HIM)。Tavus 公布的数据显示,在一项一分钟视频通话测试中,54 名参与者中有 26 人事后认为自己是在和真人聊天,比例接近 48%;作为对照,Tavus 上一代系统在同样测试中,41 个人里只骗过了 1 个,比例 2.4%。Griffin 采用「全双工、视频到视频」架构,取代过去「语音识别、大模型、语音合成、形象驱动」的级联流程,每隔不到一秒重新评估对话状态,综合语义、表情、镜头内容决定说话、点头、停顿或沉默。音视频生成方面,Tavus 自研 Tavec 音频编解码器,以 10 毫秒为单位输出声音,视频侧通过蒸馏、自回归结构与 Self-Forcing 方法实现 720p 实时生成,从听到声音到脸上做出反应平均延迟 0.43 秒。在 NVIDIA 的 VideoFDB 基准上,Griffin-Lite 在生成赛道拿到 3.83 分,感知赛道 3.73 分,均排名第一。不过该测试样本量小、未经独立验证,且 Griffin-Lite 目前只提供给少数受信任的测试者。
关键事实
- Tavus 于 10 月 1 日发布 Griffin 模型,定义为全球首个「人类交互模型」(HIM)。
- 在一分钟视频通话测试中,54 名参与者有 26 人认为自己在和真人聊天,比例接近 48%;上一代系统在 41 人中只骗过 1 人,比例 2.4%。
- Griffin 采用全双工、视频到视频架构,每隔不到一秒重新评估一次对话状态。
- Tavec 音频编解码器把 48kHz 音频压缩成每秒 100 帧、每帧 40 个数值,最小以 10 毫秒为单位输出声音,可用约 10 秒录音克隆声音。
- Griffin 以 320 毫秒为一块实时生成 720p 视频,从听到声音到脸上做出反应平均延迟 0.43 秒。
- 在 NVIDIA 的 VideoFDB 基准上,Griffin-Lite 生成赛道 3.83 分、感知赛道 3.73 分,均排名第一;人类参考值分别为 3.92 和 4.20。
为什么值得关注
如果端到端全双工模型被验证为正确方向,靠堆砌语音识别、大模型、语音合成、形象驱动四件套的产品护城河会迅速变浅。同时,让 Griffin 成为强大交互界面的特性也可能被用于深度伪造,Tavus 表示正在开发「主动披露身份」功能并与 AI 安全组织合作。
背景与影响
过去几年数字人赛道主要比拼「脸像不像」,HeyGen、Synthesia 等公司主打预先生成的口播视频,国内直播带货、政务客服数字人也多沿用同一逻辑。级联架构在实时对话中会暴露一至两秒迟滞和不合时宜的表情。2024 年 GPT-4o 用端到端语音模型取代三段式流程,Griffin 试图把这场端到端革命从声音推进到画面。
本文整理自公开报道,版权归原作者所有;文中观点仅供参考,不代表本站立场。如有版权问题,请联系我们。